 DE
 EN
 FR
 IT
 PT
 ES


SQL Server 2025 unter Linux: Praxisleitfaden
Das Ausführen von SQL Server unter Linux ist kein experimenteller Nebenweg mehr. Für Unternehmen, die bereits standardmäßig auf Red Hat Enterprise Linux oder Ubuntu setzen, ermöglicht SQL Server 2025 die Beibehaltung vertrauter Datenbanktools bei gleichzeitiger Integration der Engine in ein etabliertes Linux-Betriebsmodell. Der Reiz liegt nicht einfach darin, Windows zu meiden. Es ist die Fähigkeit, dieselben Automatisierungs-, Beobachtbarkeits-, Containerplattform-, Sicherheitskontroll- und Infrastrukturfähigkeiten zu nutzen, die bereits den Rest der Anwendungsumgebung unterstützen.
Diese Flexibilität macht Architekturentscheidungen nicht zunichte. Eine zuverlässige Produktionsbereitstellung hängt immer noch von der Auswahl einer unterstützten Distribution, der Anwendung des richtigen kumulativen Updates, der bewussten Dimensionierung von Speicher und Arbeitsspeicher, dem Schutz von Geheimnissen, dem Testen der Wiederherstellung und der Anpassung der Topologie an die richtige Edition und Lizenz ab. Dieser Leitfaden folgt diesem Weg von der ersten Designbesprechung bis zur Betriebscheckliste.
Mit einem präzisen Versionsstand beginnen
SQL Server 2025, die 17.x-Generation, wurde am 18. November 2025 allgemein verfügbar. Mit Stand vom 31. Juli 2026 ist das neueste kumulative Update CU7, veröffentlicht am 16. Juli 2026, mit der Build-Nummer 17.0.4065.4. Diese Daten sind wichtig, da „SQL Server 2025“ keine ausreichend genaue Produktionsbasislinie darstellt. Installationsaufzeichnungen, Konfigurationsmanagement und Vorfallberichte sollten ggf. Edition, Build, Linux-Distribution, Kernel und Container-Image-Digest nennen.
Kumulative Updates von Microsoft sind kumulativ: Eine neue Installation kann normalerweise direkt auf das aktuelle CU verschoben werden, anstatt jedes frühere Paket anzuwenden. Dennoch sollte ein Update zunächst eine repräsentative Nicht-Produktionsumgebung durchlaufen. Testen Sie Anwendungskonnektivität, SQL Agent-Jobs, Sicherung und Wiederherstellung, Verfügbarkeitsgruppenverhalten, Erweiterungen, Treiber und Überwachung. Halten Sie eine vereinbarte Rollback- oder Wiederherstellungsroute ein. Die offizielle SQL Server 2025 Linux-Versionshinweise sind der richtige Ort, um aktuelle Builds und bekannte Probleme vor einer Wartung zu bestätigen Fenster.
Betriebsmodell vor Installationsbefehlen wählen
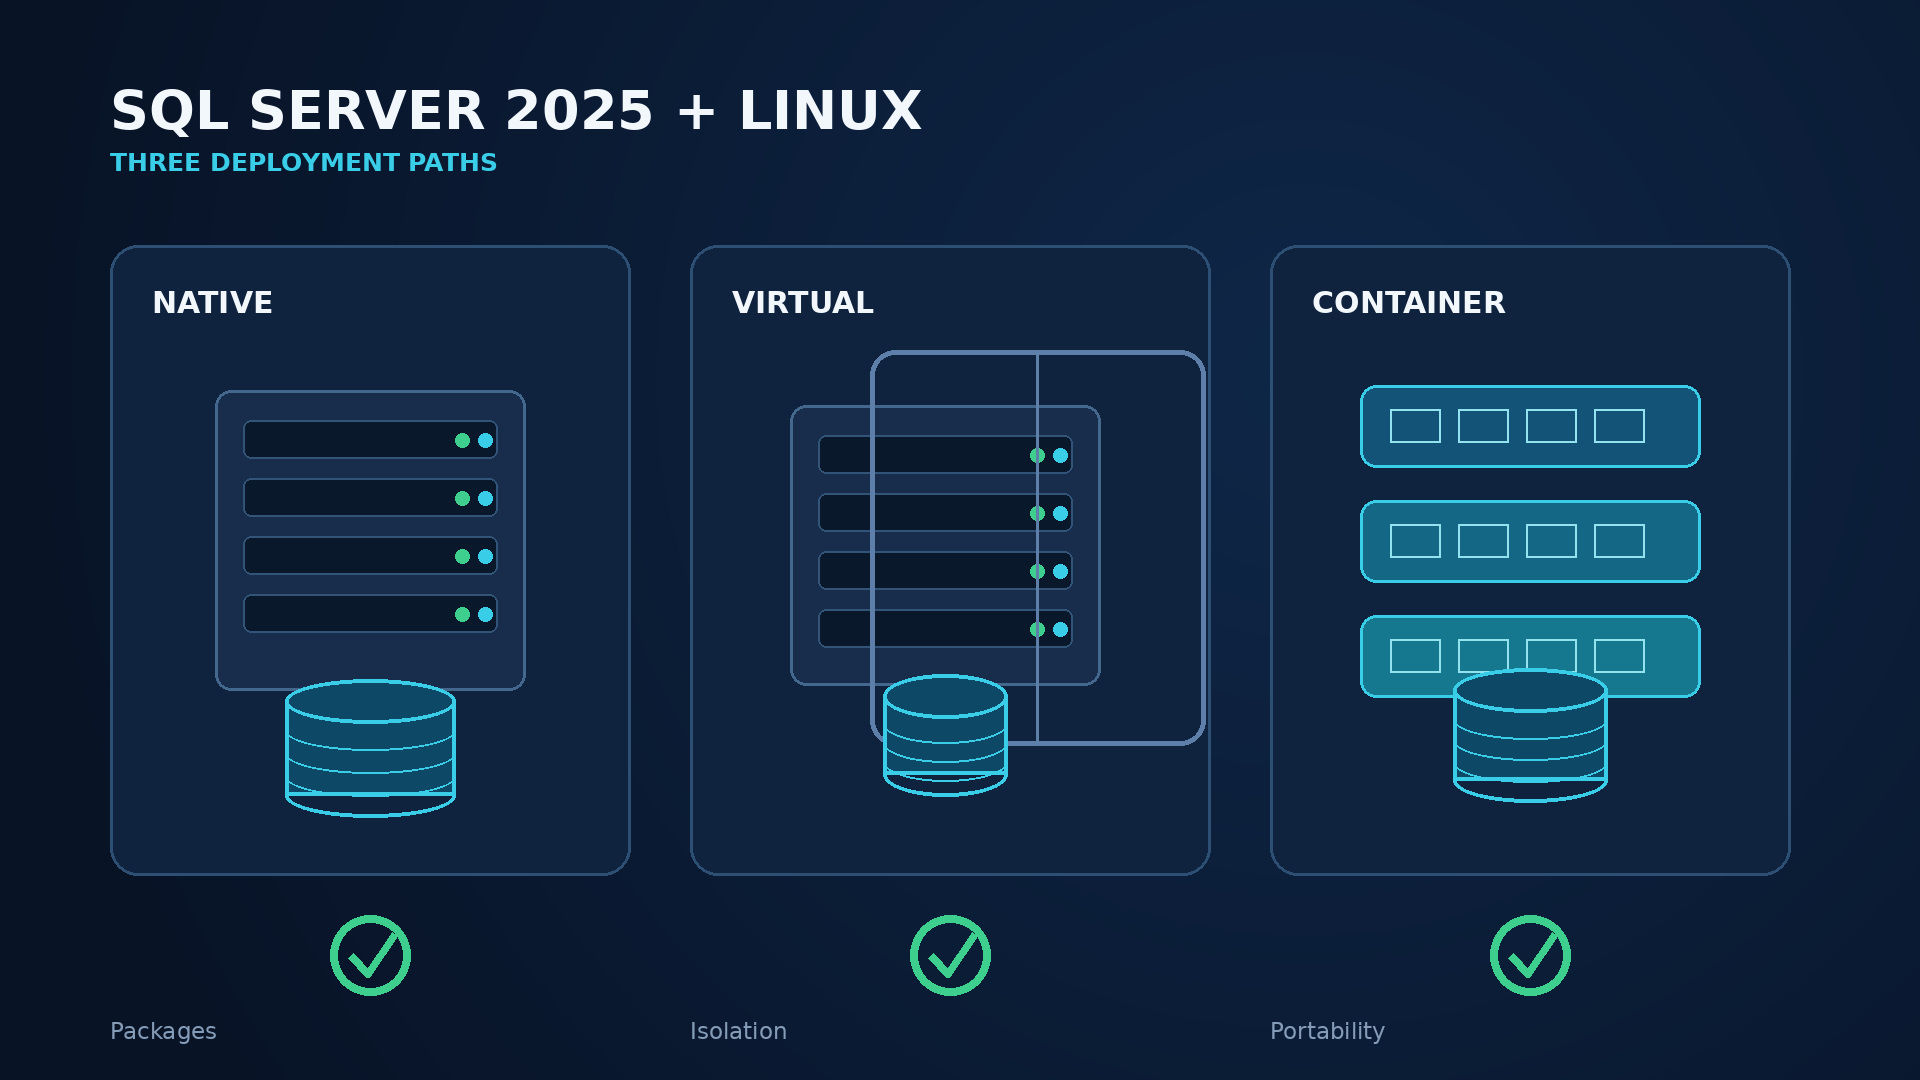
Es gibt vier gängige Muster. Bei einer nativen Paketinstallation wird SQL Server direkt auf einem unterstützten Linux-Server oder einer unterstützten virtuellen Maschine installiert. Es bietet eine unkomplizierte Systemd-Integration und ist oft die beste Wahl für stabile, langlebige Datenbank-Hosts. Eine virtuelle Maschine fügt Infrastrukturisolation, Snapshots für Infrastruktur-Workflows und bekannte Disaster-Recovery-Optionen hinzu, aber die Datenbank benötigt weiterhin SQL-fähige Sicherung und Wiederherstellung. Ein Container verpackt die Engine und die Abhängigkeiten in einem wiederholbaren Artefakt, während Persistenz, Geheimnisse und Orchestrierung der Plattform überlassen werden. Eine verwaltete Cloud-Datenbank überträgt mehr betriebliche Verantwortung auf einen Anbieter, obwohl es sich nicht um dasselbe Produkt oder dieselbe Steuerungsoberfläche wie eine selbstverwaltete Linux-Instanz handelt.
Wählen Sie Container nicht nur deshalb, weil das Anwendungsteam Kubernetes verwendet. Datenbanken haben einen dauerhaften Zustand, Wiederherstellungsziele und Latenzanforderungen. Lehnen Sie umgekehrt Container nicht ab, weil sie kurzlebig sind: Der Container kann austauschbar sein, während die Daten, Protokolle, Sicherungen und Konfigurationen korrekt beibehalten werden. Die Entscheidung sollte auf Teamfähigkeit, Standardisierung, HA-Anforderungen, Speicherintegration, Patch-Prozess und dem Grad der erforderlichen Kontrolle auf Hostebene basieren.
| Modell | Beste Passform | Hauptentwurfsaufwand |
|---|---|---|
| Nativer Host oder VM | Vorhersehbarer, langlebiger Datenbankdienst | Betriebssystemlebenszyklus, Patching und Host-HA |
| Container | Wiederholbare Bereitstellung mit ausgereifter Plattform Engineering | Persistenter Speicher, Geheimnisse, Planung und Wiederherstellung |
| Verwalteter Dienst | Teams, die vom Anbieter betriebene Infrastruktur bevorzugen | Diensteinschränkungen, Migrationsanpassung und wiederkehrendes Modell |
Unterstützte Linux-Plattformen: bewusst klar begrenzt
Für eine native SQL Server 2025-Installation Microsoft unterstützt RHEL 9 und 10 und Ubuntu 22.04 und 24.04 unter Verwendung von XFS oder ext4. RHEL 10 und Ubuntu 24.04 waren Vorschauoptionen zur allgemeinen Verfügbarkeit und wurden ab CU1 am 29. Januar 2026 vollständig unterstützt. SUSE Linux Enterprise Server wird für SQL Server 2025 nicht unterstützt. Wenn eine ältere SQL Server-Instanz derzeit auf SLES ausgeführt wird, ist ein Upgrade der vorhandenen Binärdateien nicht der Weg zu 2025; Planen Sie einen parallelen Umzug, normalerweise durch Sichern und Wiederherstellen von Datenbanken auf einem unterstützten Ziel.
Die Supportmatrix ist eine technische Grenze, kein Vorschlag. Eine Distribution, die technisch gesehen ein RPM installieren oder einen Prozess ausführen kann, ist nicht automatisch eine unterstützte Produktionsplattform. Hängen Sie die ausgewählte Hauptdistributionsversion im Architekturdatensatz an und vergleichen Sie sie mit den aktuellen Linux-Setup-Anleitungen von Microsoft. Überprüfen Sie außerdem die Unterstützungsposition der Virtualisierungsschicht, des Speichertreibers, des Clustering-Stacks und des Backup-Agenten. Die Datenbank kann unterstützt werden, während eine wesentliche umgebende Komponente dies nicht unterstützt.
Kapazität und Topologie vor der Installation planen
Beginnen Sie mit Arbeitslastnachweisen: Spitzentransaktionen pro Sekunde, gleichzeitige Sitzungen, Datenbankwachstum, Lese-/Schreibmischung, Arbeitssatzgröße, größte Abfragen, Batch-Fenster und Wiederherstellungsziele. Mindestinstallationsanforderungen beschreiben keinen fehlerfreien Produktionsserver. SQL Server konkurriert um CPU, Speicher und I/O mit dem Kernel, Sicherheitsagenten, Backup-Software und Überwachung. Lassen Sie expliziten Spielraum, anstatt jede Ressource der Datenbank zuzuweisen.
Trennen Sie Kapazität und Verfügbarkeit. Eine große VM ist nicht nur deshalb hochverfügbar, weil sie über viele Kerne verfügt. Ein Cluster mit zwei Knoten ist nicht belastbar, wenn beide Knoten, ihr Speicher und ihr Quorum von einer Fehlerdomäne abhängen. Zeichnen Sie die Abhängigkeiten: Compute-Hosts, Racks oder Zonen, DNS, Identität, Zeitdienst, Netzwerkpfade, Speicher, Zeuge, Backup-Ziel und Verwaltungsebene. Markieren Sie dann, welche Fehler das Design tolerieren kann und wie es sich von den anderen erholt.
Beachten Sie für SQL Server Standard die Obergrenze der Rechenkapazität: Eine Datenbank-Engine-Instanz kann den kleineren von vier Sockets oder 32 Kernen verwenden. Im Lizenzierungsleitfaden wird das Standardlimit auch mit 32 lizenzierten Kernen angegeben. Durch das Hinzufügen von vCPUs über das unterstützte Limit hinaus wird Standard nicht in Enterprise umgewandelt und kann Kosten und Compliance erschweren. Wenn die Arbeitslast wirklich mehr Rechenleistung, erweiterte Online-Vorgänge oder umfassendere HA-Funktionen erfordert, vergleichen Sie Enterprise, bevor Sie die Plattform fertigstellen.
Native Installation auf RHEL oder Ubuntu
Ein Produktions-Build sollte automatisiert werden, aber Administratoren sollten verstehen, was die Automatisierung bewirkt. Der typische Arbeitsablauf besteht darin, ein unterstütztes Betriebssystem bereitzustellen, es zu patchen, DNS und Zeitsynchronisierung zu konfigurieren, Datenvolumes bereitzustellen, das signierte Paket-Repository von Microsoft hinzuzufügen, das Paket mssql-server zu installieren, die Ersteinrichtung auszuführen, die Edition auszuwählen, die Bedingungen zu akzeptieren, die Anmeldeinformationen des Systemadministrators sicher festzulegen und den Systemd-Dienst zu starten. Client-Tools wie sqlcmd können separat auf administrativen Hosts installiert werden.
Platzieren Sie kein echtes Administratorkennwort im Shell-Verlauf, in Cloud-Init-Protokollen oder in einem Konfigurations-Repository. Nutzen Sie den Secret Manager der Organisation und einen kontrollierten Bootstrap-Prozess. Überprüfen Sie nach der Einrichtung systemctl status mssql-server, überprüfen Sie das SQL Server-Fehlerprotokoll, stellen Sie eine lokale Verbindung mit Verschlüsselung her und fragen Sie SERVERPROPERTY('ProductVersion'), SERVERPROPERTY('Edition') und die konfigurierten Datenpfade ab. Wenden Sie die genehmigte CU an, bevor Sie Produktionsdaten integrieren.
Verschieben Sie Standarddaten- und Protokollverzeichnisse nur durch dokumentierte SQL Server-Konfiguration, nicht durch improvisierte symbolische Links. Legen Sie den Besitz und die Berechtigungen für das mssql-Konto eng fest. Öffnen Sie TCP 1433 nur dort, wo es erforderlich ist. Ein Standardport, der einem gesamten Netzwerk zugänglich gemacht wird, ist keine Bereitstellungsleistung. Definieren Sie explizit Firewall-Quellen, Verwaltungsrouten und Anwendungsverbindungszeichenfolgen. Notieren Sie abschließend jede nicht standardmäßige mssql-conf-Einstellung in der Dokumentation der versionierten Infrastruktur.
Container: reproduzierbar heißt nicht zustandslos
Microsoft unterstützt SQL Server 2025-Container-Images auf x86-64-Linux-Hosts mit Intel- oder AMD-Prozessoren. Übersetzungs- und Emulationsumgebungen wie Rosetta 2, Prism und QEMU werden nicht getestet oder unterstützt. Hängen Sie ein Produktionsbild an ein genehmigtes CU-Tag und vorzugsweise an einen unveränderlichen Digest an. Die Verwendung eines Floating-Tags macht es schwierig nachzuweisen, was sich zwischen Neustarts geändert hat.
Der Container sollte als Nicht-Root-Benutzer ausgeführt werden, sein Geheimnis über den Orchestrator oder den Geheimspeicher erhalten und dauerhaften Speicher für /var/opt/mssql oder ein bewusst getrenntes Datenlayout verwenden. Validieren Sie die Speicherklasse auf Latenz, Durchsatz, Fsync-Verhalten, Failover-Anhang und Snapshots. Ein Volume, das für einen Web-Cache geeignet ist, ist möglicherweise für ein schreibintensives Transaktionsprotokoll ungeeignet. Legen Sie CPU- und Speicheranforderungen und -grenzen mit gemessenem Spielraum fest. SQL Server 2025 versteht cgroup v2 und verbessert so das Bewusstsein für die von modernen Linux- und Containerplattformen zugewiesenen Ressourcen, aber schlechte Grenzwerte führen immer noch zu schlechter Leistung.
Gesundheitsprüfungen sollten „der Prozess existiert“ von „die Datenbank akzeptiert nützliche Arbeit“ unterscheiden. Fügen Sie Startup-Zulage für die Wiederherstellung nach einem Absturz hinzu, vermeiden Sie Neustartschleifen, die die Wiederherstellung unterbrechen, und leiten Sie den Anwendungsverkehr vor dem geplanten Pod-Austausch ab. Sicherungen müssen die Fehlerdomäne des Containers verlassen. Testen Sie die Wiederherstellung in einer sauberen Instanz, die auf demselben dokumentierten Image und derselben Konfiguration basiert.
Performance: zuerst den E/A-Pfad entwerfen
Datenbankleistung unter Linux wird normalerweise durch eine Kombination aus Abfragequalität, Speicherdruck und Speicherlatenz gewonnen oder verloren. Separate Daten, Transaktionsprotokolle, tempdb und Backups, bei denen die Speicherarchitektur wirklich unabhängige Leistungs- oder Fehlermerkmale bereitstellen kann. Das bloße Erstellen von vier Verzeichnissen auf demselben gesättigten Gerät sorgt für organisatorische Ordnung und nicht für vier E/A-Pfade. Messen Sie die Lese- und Schreiblatenz auf der SQL Server- und Betriebssystemebene, auch während Sicherungen, Prüfpunkten und Wartungsspitzen.
Legen Sie den maximalen Serverspeicher für SQL Server fest, damit das Betriebssystem, die Treiber und Agenten ausreichend Speicher behalten. Achten Sie auf Auslagerungen und anhaltenden Speicherdruck, anstatt sich auf eine einzelne Nummer mit freiem Speicher zu verlassen. Richten Sie die vCPU-Topologie und das NUMA-Design an den Hypervisor und die Arbeitslast aus. Zu große VMs können zu Planungsnachteilen führen, während zu kleine Systeme zu ausführbaren Warteschlangen und instabilen Latenzzeiten führen. Verwenden Sie tatsächliche Wartestatistiken, Abfragespeicher und Ausführungspläne, um CPU-, E/A-, Sperr-, Speichergewährungs- und Abfrageentwurfsprobleme zu unterscheiden.
SQL Server 2025 unterstützt das Platzieren von tempdb auf tmpfs. Dies kann für geeignete temporäre Workloads wertvoll sein, da tmpfs speichergestützt ist, aber es ist flüchtig, verbraucht Speicher und kann den Druck an anderer Stelle erhöhen. In dieser Anordnung wird nur tempdb unterstützt; Platzieren Sie dort niemals Benutzerdatenbanken oder persistente Systemdatenbanken. Bemessen Sie es konservativ, legen Sie das Dateiwachstum bewusst fest, berücksichtigen Sie das Neustartverhalten und führen Sie einen Lasttest im schlimmsten Spill- oder Versionsspeicher-Szenario durch. Microsofts tmpfs-Konfigurationsleitfaden sollte genau befolgt werden.
Die Wartung bleibt arbeitslastspezifisch. Aktualisieren Sie Statistiken in angemessener Häufigkeit, verwalten Sie den Indexzustand basierend auf dem gemessenen Nutzen, sorgen Sie dafür, dass die Aufbewahrung des Abfragespeichers sinnvoll bleibt, und überprüfen Sie teure Pläne nach Upgrades. Die generische ODBC-Konnektivität für PolyBase erweitert die externen Datenquellenoptionen unter Linux, Remote-Scans hängen jedoch weiterhin von der Treiberqualität, der Netzwerklatenz, dem Prädikat-Pushdown und der Quellkapazität ab. Behandeln Sie die Föderation als Integrationsdesign und nicht als kostenlosen lokalen Speicher.
Sicherheit: Linux nutzen, ohne blinde Flecken zu schaffen
SQL Server 2025 unter Linux aktiviert TLS 1.3 standardmäßig. Das ist eine starke Grundlinie, aber die Verschlüsselung ist erst dann abgeschlossen, wenn Clients das Serverzertifikat validieren und Administratoren die Vertrauenswürdigkeit kontrollieren. Verwenden Sie ein für den Dienstnamen ausgestelltes Zertifikat, schützen Sie seinen privaten Schlüssel, automatisieren Sie die Erneuerung sicher und testen Sie ältere Treiber, bevor Änderungen durchgesetzt werden. Vermeiden Sie die Behebung von Zertifikatsfehlern, indem Sie jeden Client so einstellen, dass er jedem Serverzertifikat vertraut.
Bevorzugen Sie zentral verwaltete Identitäten, wenn die Anwendungsarchitektur sie unterstützt, verwenden Sie separate Dienstidentitäten und gewähren Sie die minimalen Datenbankrechte. SQL Server 2025 fügt benutzerdefinierte Passwortrichtlinien für SQL-Anmeldungen hinzu, was nützlich ist, wenn die SQL-Authentifizierung nicht entfernt werden kann. Eine Richtlinie sollte Länge, Komplexität, Verlauf, Aussperrung und Rotation im Einklang mit dem Risikomodell der Organisation definieren; Es sollte keine vorhersehbaren monatlichen Passwortvariationen fördern. Sorgen Sie dafür, dass der administrative Notfallzugriff geschützt, geprüft und getestet wird.
Minimieren Sie auf der Hostebene installierte Pakete, schränken Sie die interaktive Anmeldung ein, halten Sie die Sudo-Mitgliedschaft auf ein Minimum beschränkt, erzwingen Sie Dateiberechtigungen und überwachen Sie Änderungen an Konfiguration und Zertifikaten. Verwenden Sie Firewall-Zulassungslisten zwischen Anwendungen, Administratoren, Clusterknoten und Überwachungssystemen. Behalten Sie SELinux oder die obligatorischen Steuerelemente der Distribution in der unterstützten Konfiguration bei, anstatt den Schutz zu deaktivieren, damit eine Installation „funktioniert“. Senden Sie SQL-Prüfungsinformationen, Authentifizierungsfehler, Systemereignisse und Host-Sicherheitsprotokolle an eine zentrale Plattform mit einer für das Unternehmen geeigneten Aufbewahrung.
Patching gehört zu Sicherheit und Zuverlässigkeit. Pflegen Sie einen wiederkehrenden Zyklus für den Linux-Kernel, SQL Server CU, Treiber, Befehlszeilentools, Sicherungssoftware und Container-Basisimage. Definieren Sie, welche Updates einen Neustart oder ein Failover erfordern, wer den Dienst anschließend validiert und welche Beweise die Änderung abschließen. Beim Schwachstellenscan sollte der Unterschied zwischen einer Image-Ebene, einem installierten Paket und einem laufenden, gepatchten Datenbankprozess verstanden werden.
Hochverfügbarkeit: den abzusichernden Fehler definieren
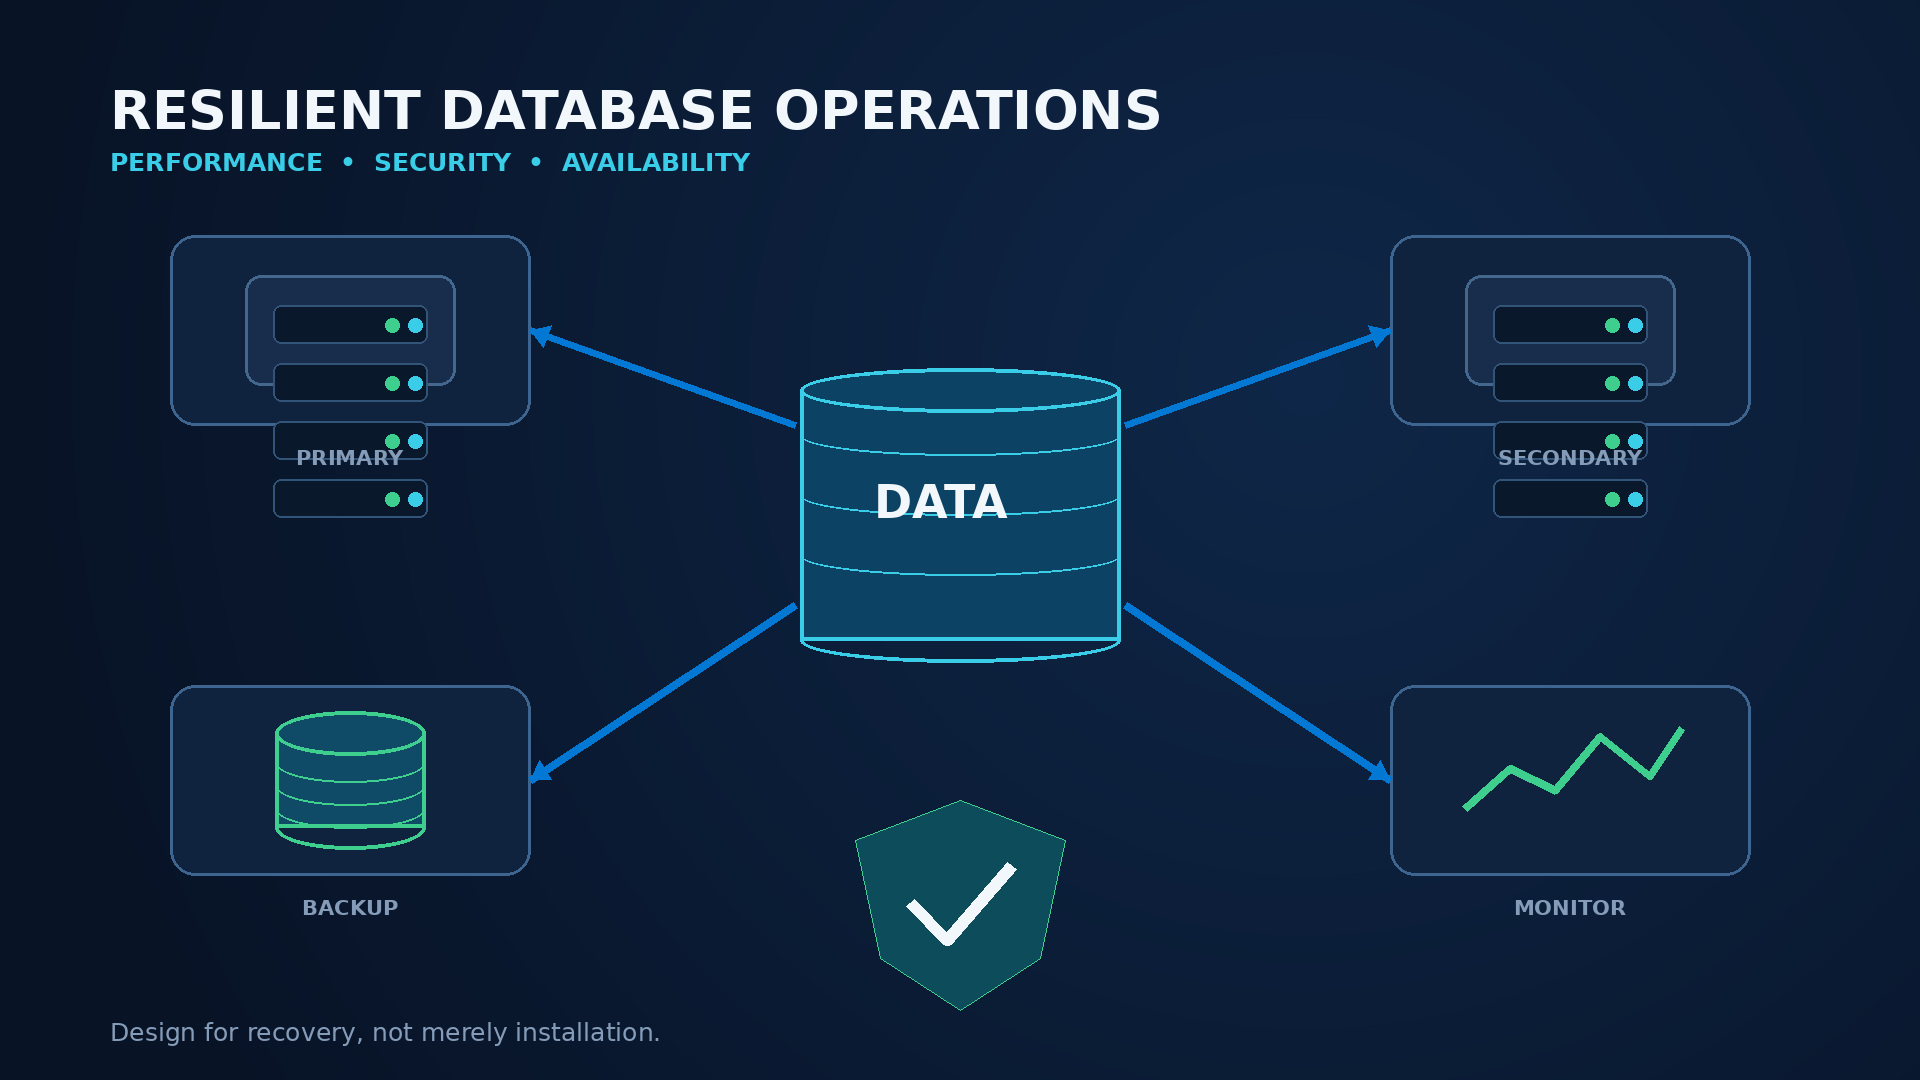
SQL Server unter Linux unterstützt Failover-Cluster-Instanzen und Verfügbarkeitsgruppen mit Pacemaker-basierter Orchestrierung, löst jedoch unterschiedliche Probleme. Eine FCI schützt eine Instanz und ist normalerweise auf gemeinsam genutzten Speicher angewiesen. Eine Verfügbarkeitsgruppe repliziert ausgewählte Benutzerdatenbanken zwischen Replikaten und kann je nach Edition und Konfiguration lesbare Kopien oder Kopien für die Notfallwiederherstellung bereitstellen. Weder ersetzt Backups, noch schützt es eine Anwendung, wenn DNS, Identität, Quorum oder ein gemeinsam genutzter Netzwerkpfad ein Single Point of Failure bleiben.
Schreiben Sie zuerst Wiederherstellungsziele. RTO beschreibt, wie schnell der Dienst wiederhergestellt werden soll; RPO beschreibt, wie viel begangener Datenverlust akzeptabel ist. Die synchrone Replikation kann den Datenverlust im vorgesehenen Fehlerbereich reduzieren, erhöht jedoch die Latenz und erfordert dennoch eine korrekte Failover-Richtlinie. Für entfernte Disaster-Recovery-Standorte ist die asynchrone Replikation oft besser, da eine potenzielle Datenlücke in Kauf genommen werden muss. Dokumentieren Sie, ob das Failover automatisch oder manuell erfolgt, welche Datenbanken zusammen verschoben werden, wie Anmeldungen und Jobs synchronisiert werden und wie Anwendungen die neue Primärdatenbank erkennen.
Pacemaker benötigt Quorum, Fencing und getestete Ressourcenagenten. Einzäunung ist keine optionale Dekoration: Sie verhindert, dass zwei Knoten glauben, dass ihnen derselbe Dienst oder Speicher gehört. Platzieren Sie Knoten und Zeugen über sinnvolle Fehlerdomänen hinweg, halten Sie die Zeit synchronisiert und testen Sie den Ausfall eines Knotens, eines Netzwerksegments, eines Speicherpfads und eines Zeugen. Die Standard-Edition verfügt über engere Verfügbarkeitsgruppenfunktionen als die Enterprise-Edition. Überprüfen Sie daher die genauen Funktionsgrenzen, bevor Sie eine Topologie versprechen. Die Linux-Verfügbarkeitsgruppenübersicht von Microsoft ist ein Ausgangspunkt und kein Ersatz für ein Runbook.
Backups: Entscheidend ist die Wiederherstellung
Ein Sicherungsjob, der den Erfolg meldet, ist nur ein Input für die Wiederherstellbarkeit. Definieren Sie vollständige, differenzielle und Transaktionsprotokoll-Zeitpläne aus dem RPO. Wählen Sie die Aufbewahrung entsprechend betrieblicher, vertraglicher und regulatorischer Anforderungen. Backups verschlüsseln; und Kopien außerhalb des Datenbankhosts und außerhalb der primären Fehlerdomäne speichern. Schützen Sie Backup-Anmeldeinformationen getrennt von Datenbankadministrator-Anmeldeinformationen, damit bei einer Kompromittierung nicht sowohl Produktions- als auch Wiederherstellungskopien gelöscht werden.
Verwenden Sie native SQL Server-Backups für eine datenbankkonsistente Wiederherstellung. Infrastruktur-Snapshots können diese ergänzen, wenn sie koordiniert und unterstützt werden, aber ein absturzkonsistentes Disk-Image ist nicht automatisch ein Ersatz für eine getestete Datenbank-Backup-Kette. Überwachen Sie Backup-Alter, -Dauer, -Durchsatz und -Fehler. Überprüfen Sie ggf. Prüfsummen, führen Sie Integritätsprüfungen durch und halten Sie ausreichend freien Speicherplatz für Notfallwiederherstellungen bereit.
Wiederherstellungstests sollten geplant, gemessen und dokumentiert werden. Stellen Sie eine saubere Umgebung wieder her, stellen Sie die Wiederherstellung zu einem ausgewählten Zeitpunkt her, führen Sie Integritätsprüfungen durch, überprüfen Sie Benutzer und Anwendungszugriff und vergleichen Sie die erreichte RTO mit dem Ziel. Testen Sie auch die Wiederherstellung verschlüsselter Sicherungsschlüssel und Zertifikate. Das Microsoft-Sicherungs- und Wiederherstellungshandbuch für Linux behandelt unterstützte Mechanismen; Die Organisation muss Eigentum, Aufbewahrung und Probe hinzufügen.
Monitoring: SQL-Server- und Linux-Signale zusammenführen
Überwachung von der Benutzertransaktion abwärts. Zu den Service-Level-Indikatoren können erfolgreiche Anfragen, Latenz und Fehlerrate gehören. Zu den SQL Server-Signalen gehören Wartezeiten, Blockierungen, Deadlocks, Kompilierungen, Regressionen des Abfragespeichers, Protokollnutzung, Datenbankstatus, AG-Warteschlangen, Sicherungsalter und Jobfehler. Zu den Linux-Signalen gehören CPU-Auslastung, Ausführungswarteschlange, Speicherauslastung, Swap, Dateisystemkapazität, E/A-Latenz, Netzwerkfehler und Systemneustarts. Containerbereitstellungen fügen Drosselungs-, Räumungs-, Volumen- und Zeitplanerereignisse hinzu.
Verwenden Sie Baselines statt universeller Schwellenwerte. Achtzig Prozent der CPU können für einen Batch-Server gesund und für einen latenzempfindlichen Dienst ohne Burst-Raum katastrophal sein. Warnen Sie bei anhaltenden Bedingungen und Benutzerauswirkungen, unterdrücken Sie bekannte Wartungsgeräusche und machen Sie jede Seite umsetzbar. Armaturenbretter ohne Besitz werden zur Wanddekoration. Für jede kritische Warnung sind ein erster Diagnoseschritt, ein Eskalationspfad und ein Link zum entsprechenden Runbook erforderlich.
Zentralisieren Sie das SQL Server-Fehlerprotokoll und relevante Journaleinträge, sammeln Sie jedoch nicht wahllos Geheimnisse oder den gesamten vertraulichen Abfragetext. Halten Sie die Zeit synchronisiert, damit Ereignisse über Anwendungen, Proxys, SQL Server, Pacemaker und Speicher hinweg korreliert werden können. Überprüfen Sie die Überwachung nach jedem Vorfall: Wenn die Antwortenden unter Druck eine Abfrage oder einen Befehl erfinden mussten, fügen Sie sie dem Dashboard oder Runbook hinzu.
Migration zu SQL Server 2025 unter Linux
Eine parallele Migration ist normalerweise sicherer, als eine Betriebssystemänderung als routinemäßiges In-Place-Upgrade zu behandeln. Inventardatenbanken, Kompatibilitätsstufen, Sortierungen, SQL-Agent-Jobs, Verbindungsserver, CLR-Komponenten, Dateipfade, Zertifikate, Anmeldeinformationen, Replikation, externe Datenquellen, Treiber und Betriebsskripts. Identifizieren Sie Windows-Abhängigkeiten wie Laufwerksbuchstaben, lokale Windows-Konten, Dateiannahmen ohne Berücksichtigung der Groß-/Kleinschreibung, reine PowerShell-Jobs oder nicht unterstützte Komponenten. Klassifizieren Sie jedes Element als portabel, ersetzbar, für eine Neugestaltung erforderlich oder für den Ruhestand in Frage.
Verwenden Sie frühzeitig eine repräsentative Testwiederherstellung auf dem Ziel. Führen Sie Datenbankkonsistenzprüfungen, ggf. Upgrade-Berater, Anwendungstests und Leistungsbaselines durch. Behalten Sie zunächst den ursprünglichen Kompatibilitätsgrad bei, wenn dadurch die Änderung reduziert wird, und bewerten Sie dann das Verhalten des Optimierers für 2025 anhand von Abfragespeichernachweisen. Überprüfen Sie die Sortierung und das Groß-/Kleinschreibungsverhalten sorgfältig: Bei Linux-Pfaden wird die Groß-/Kleinschreibung beachtet, auch wenn dies bei einer Datenbanksortierung nicht der Fall ist.
Für kleine Datenbanken mit einem akzeptablen Ausfall können Sicherung, Kopieren, Wiederherstellen und Umleiten ausreichend sein. Größere Migrationen oder Migrationen mit geringer Ausfallzeit können je nach Quellversion und Edition Protokollversandmuster, Verfügbarkeitsgruppen, Replikation oder andere unterstützte Datenverschiebungsmethoden verwenden. Jeder Ansatz erfordert einen Umstellungsplan mit Schreibstopp, endgültiger Synchronisierung, Validierung, Änderung der Verbindungszeichenfolge, geschäftlicher Freigabe und Rollback-Grenze. Demontieren Sie die Quelle nicht, bis Backups, Beobachtbarkeit und eine stabile Betriebsdauer den neuen Dienst bestätigen.
SQL Server 2025 Standard verantwortungsvoll lizenzieren
Beginnen Sie mit der Trennung von Editionsauswahl, technischen Einschränkungen und Lizenzrechten. Der Standard eignet sich möglicherweise gut für viele Abteilungs- und mittelgroße Workloads, aber die Obergrenze für die Berechnung von 32 Kernen pro Instanz und die Funktionsbeschränkungen müssen zum Design passen. Microsoft bietet verschiedene Lizenzmodelle und Virtualisierungsregeln an; Die korrekte Berechnung hängt von den physischen Kernen, den virtuellen Maschinen, dem Zugriffsmuster und den mit der Lizenz verbundenen Rechten ab. Lesen Sie die aktuellen Microsoft SQL Server-Lizenzierungsrichtlinien und Produktbedingungen für die endgültige Entscheidung.
Licendi bietet eine legitime gebrauchte Lizenz für SQL Server 2025 Standard für Organisationen, die eine unbefristete Lizenzierungsroute suchen. Bei einer verantwortungsvollen Kaufprüfung sollten die Rechnung, die Produktbeschreibung, die Lizenzdokumentation und die für die Transaktion bereitgestellten Übertragungs-/Herkunftsnachweise aufbewahrt werden. Vergewissern Sie sich vor dem Kauf und erneut vor der Produktionsaktivierung, dass Menge, Edition, Metrik und Bereitstellungstopologie mit dem technischen Design übereinstimmen.
Gebrauchtlizenzen können in relevanten Gerichtsbarkeiten eine gültige Beschaffungsoption sein, sind jedoch kein Grund zum Vermuten. Komplexe Cluster, Hosting-Vereinbarungen, Cloud-Mobilität, häufige VM-Bewegungen oder gemischte physische/virtuelle Umgebungen verdienen eine fachkundige Prüfung. Führen Sie Lizenzaufzeichnungen zusammen mit dem Konfigurationsinventar, damit Infrastrukturänderungen eine Konformitätsprüfung auslösen, anstatt sich auf eine Tabelle zu verlassen, die bei einem Audit entdeckt wurde.
Praktische Bereitstellungscheckliste
Architektur und Support
- Geschäftsinhaber, technischer Eigentümer, Datenklassifizierung, RTO und RPO aufzeichnen.
- Nativen Host, VM oder Container basierend auf Betrieb und Wiederherstellung auswählen – nicht auf Mode.
- Wählen Sie RHEL 9/10 oder Ubuntu 22.04/24.04 und Cluster-Komponente und Backup-Agent werden unterstützt.
- Überprüfen Sie, ob die 32-Core-Computing-Obergrenze von Standard zur Instanz passt.
Bereitstellung und Sicherheit
- Automatisieren Sie die Repository-Konfiguration, die Paketinstallation und genehmigte Einstellungen.
- Geheimnisse aus einem Tresor abrufen; Halten Sie sie von Skripten, Bildern und dem Shell-Verlauf fern.
- Installieren Sie ein Dienstzertifikat und testen Sie TLS 1.3 mit Produktions-Client-Treibern.
- Beschränken Sie Firewall-Regeln, Sudo, Dateibesitz und interaktiven Zugriff.
- Aktivieren Sie die erforderliche Überwachung und leiten Sie Datenbank- und Host-Sicherheitsereignisse zentral weiter.
- Dokumentieren Sie den wiederkehrenden Patch-Zyklus für Betriebssystem, CU, Treiber und Container-Image.
Performance und Daten
- Größe aus gemessener Arbeitslast, Wachstum und Wartungsspitzen.
- Reservieren Sie Arbeitsspeicher und CPU-Spielraum für Linux und operative Agenten.
- Validieren Sie die Latenz und Haltbarkeit von Daten, Protokollen, Tempdb und Backup-Speicher.
- Stellen Sie den maximalen Serverspeicher und das Dateiwachstum bewusst ein.
- Verwenden Sie tmpfs nur für Tempdb, mit einer getesteten Kapazität und einem Neustartplan.
- Erfassen Sie eine Vorproduktion Abfragespeicher und Betriebssystem-Baseline.
Verfügbarkeit und Wiederherstellung
- Fehlerdomänen zuordnen und versehentliche gemeinsame Abhängigkeiten entfernen.
- Quorum, Fencing, Listener/DNS und Failover-Richtlinie explizit konfigurieren.
- Knoten-, Netzwerk-, Speicher-, Zeugen- und Replikat-Fehlerszenarien testen.
- Sicherungen verschlüsseln und Kopien außerhalb der primären Fehlerdomäne aufbewahren.
- Leistung und Zeitaufwand eine saubere Wiederherstellung, einschließlich Schlüsseln und Point-in-Time-Wiederherstellung.
- Schreiben Sie Anwendungswiederverbindungs-, Failover-, Eskalations- und Rollback-Runbooks.
Betrieb und Lizenzierung
- Warnung zu Benutzerauswirkungen, SQL-Wartezeiten, Blockierung, Kapazität, AG-Zustand und Backup-Alter.
- Korrelieren Sie SQL-, Systemd-, Betriebssystem-, Container-, Cluster- und Speichertelemetrie.
- Weisen Sie einen Besitzer zu und Erste Aktion bei jeder kritischen Warnung.
- Inventarisierung von Jobs, Anmeldungen, Zertifikaten, Treibern und Abhängigkeiten vor der Migration.
- Validieren Sie Lizenzmodell, Metrik, Mengen, Beweise und Topologie.
- Planen Sie eine Überprüfung der Leistung, Sicherheit, Wiederherstellung und Compliance nach dem Start.
Fazit
SQL Server 2025 unter Linux ist am erfolgreichsten, wenn es als Datenbankdienst betrieben und nicht nur als anderer installiert wird Paket. Unterstützte Plattformen, eine präzise CU-Baseline, langlebiger Speicher, sorgfältige Ressourcenkontrollen, Zertifikatsvalidierung, eingespielte Wiederherstellung und nützliche Überwachung sind alles Teile desselben Designs. Linux bietet Teams starke Grundlagen für Automatisierung und Beobachtbarkeit. SQL Server fügt seine eigenen Status-, Transaktions- und Lizenzierungsverantwortlichkeiten hinzu.
Erstellen Sie das Betriebsmodell vor dem Produktionsserver, testen Sie die Fehlerpfade, bevor Sie Verfügbarkeit versprechen, und verbinden Sie die Lizenzbeschaffung mit der tatsächlichen Topologie. Durch diese Disziplin entsteht eine Plattform, die einfacher zu patchen, zu erklären, wiederherzustellen und zu prüfen ist – und SQL Server 2025 einen stabilen Platz in einer Linux-First-Umgebung verschafft.
Häufig gestellte Fragen
Welche Linux-Distributionen unterstützen SQL Server 2025?
Microsoft unterstützt native Installationen auf RHEL 9 und 10 und Ubuntu 22.04 und 24.04 mit XFS oder ext4. RHEL 10 und Ubuntu 24.04 werden ab CU1 vollständig unterstützt.
Unterstützt SQL Server 2025 SLES?
Nein. SLES ist keine unterstützte SQL Server 2025-Plattform. Migrieren Sie eine ältere SLES-gehostete Instanz zu einem unterstützten RHEL- oder Ubuntu-Ziel, normalerweise über einen parallelen Sicherungs- und Wiederherstellungsplan.
Was ist das neueste SQL Server 2025 Linux-Update?
Stand: 31. Juli 2026: CU7, Build 17.0.4065.4, veröffentlicht am 16. Juli 2026. Überprüfen Sie vorher immer die Versionshinweise noch einmal Bereitstellung.
Kann SQL Server 2025 in einem Linux-Container ausgeführt werden?
Ja, auf unterstützten x86-64-Linux-Hosts mit Intel- oder AMD-Prozessoren. Datenbankspeicher beibehalten, Image-Version anpinnen, Geheimnisse schützen und Sicherung und Wiederherstellung außerhalb des Containers testen.
Kann ich SQL Server-Datenbanken auf tmpfs ablegen?
Nur tempdb wird auf tmpfs unterstützt. Es ist flüchtig und speichergestützt, also dimensionieren und testen Sie es sorgfältig. Benutzerdatenbanken und persistente Systemdatenbanken müssen auf dauerhaft unterstütztem Speicher verbleiben.
Verwendet die Standard Edition mehr als 32 Kerne?
Eine Standard Database Engine-Instanz ist auf den kleineren von vier Sockets oder 32 Kernen beschränkt. Lizenzierungs- und Virtualisierungsregeln müssen noch für die tatsächliche Bereitstellung überprüft werden.
Ersetzen Verfügbarkeitsgruppen Backups?
Nein. Die Replikation kann die Verfügbarkeit verbessern, aber auch Löschungen oder Beschädigungen reproduzieren. Bewahren Sie unabhängige verschlüsselte Sicherungen auf und führen Sie geplante Wiederherstellungstests durch.
Ist eine gebrauchte SQL Server-Lizenz legitim?
Es kann sich um einen legitimen Beschaffungsweg handeln, bei dem die rechtlichen und Lizenzübertragungsbedingungen erfüllt sind. Bewahren Sie Transaktions- und Herkunftsdokumente auf und validieren Sie Edition, Metrik und Topologie für die beabsichtigte Bereitstellung.




