 IT
 EN
 FR
 DE
 PT
 ES


SQL Server 2025 su Linux: guida pratica al deployment
L'esecuzione di SQL Server su Linux non è più una strada secondaria sperimentale. Per le organizzazioni che già adottano Red Hat Enterprise Linux o Ubuntu come standard, SQL Server 2025 consente di mantenere gli strumenti di database familiari integrando al tempo stesso il motore in un modello operativo Linux consolidato. Il vantaggio non consiste semplicemente nell’evitare Windows. È la capacità di utilizzare la stessa automazione, osservabilità, piattaforme container, controlli di sicurezza e competenze infrastrutturali che già supportano il resto del patrimonio applicativo.
Tale flessibilità non elimina le decisioni sull'architettura. Una distribuzione di produzione affidabile dipende ancora dalla scelta di una distribuzione supportata, dall'applicazione del giusto aggiornamento cumulativo, dal dimensionamento deliberato dello spazio di archiviazione e della memoria, dalla protezione dei segreti, dal test del ripristino e dalla corrispondenza della topologia con l'edizione e la licenza corrette. Questa guida segue il percorso dal primo incontro di progettazione all'elenco di controllo operativo.
Partire da una baseline di versione precisa
SQL Server 2025, la generazione 17.x, è diventata disponibile a livello generale il 18 novembre 2025. Al 31 luglio 2026, l'ultimo aggiornamento cumulativo è CU7, rilasciato il 16 luglio 2026, con numero di build 17.0.4065.4. Queste date sono importanti perché “SQL Server 2025” non è una linea di base di produzione sufficientemente precisa. I record di installazione, la gestione della configurazione e i report sugli incidenti devono indicare l'edizione, la build, la distribuzione Linux, il kernel e il digest dell'immagine del contenitore, ove applicabile.
Gli aggiornamenti cumulativi di Microsoft sono cumulativi: una nuova installazione può normalmente passare direttamente alla CU corrente anziché applicare tutti i pacchetti precedenti. Tuttavia, un aggiornamento dovrebbe prima passare attraverso un ambiente rappresentativo non di produzione. Testare la connettività delle applicazioni, i processi di SQL Agent, il backup e il ripristino, il comportamento dei gruppi di disponibilità, le estensioni, i driver e il monitoraggio. Mantenere un percorso concordato di rollback o ripristino. Le note ufficiali sulla versione di SQL Server 2025 Linux sono il posto giusto per confermare le build correnti e i problemi noti prima di una finestra di manutenzione.
Scegliere il modello operativo prima dei comandi
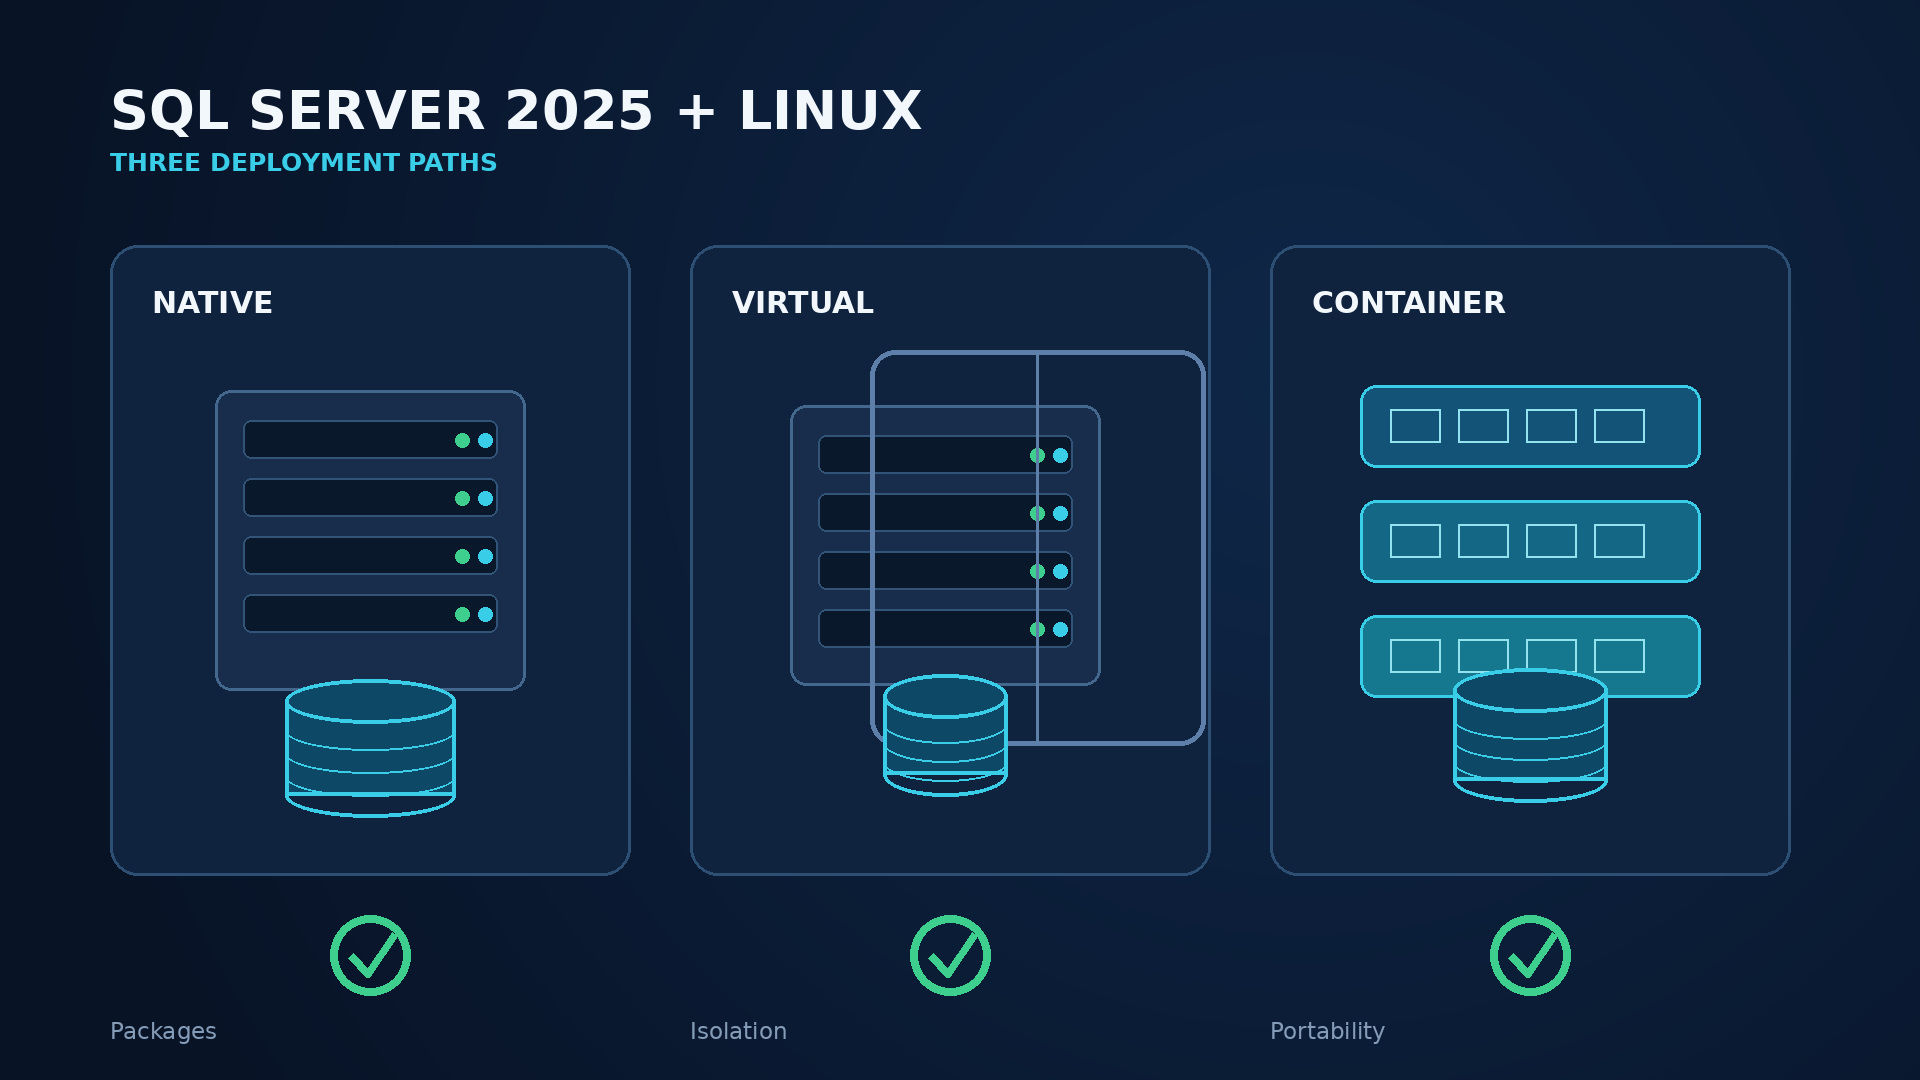
Esistono quattro modelli comuni. L'installazione di un pacchetto nativo inserisce SQL Server direttamente in una macchina virtuale o in un server Linux supportato. Offre un'integrazione semplice con Systemd ed è spesso la scelta più chiara per host di database stabili e di lunga durata. Una macchina virtuale aggiunge isolamento dell'infrastruttura, snapshot per i flussi di lavoro dell'infrastruttura e opzioni familiari di ripristino di emergenza, ma il database necessita comunque di backup e ripristino compatibili con SQL. Un contenitore racchiude il motore e le dipendenze in un artefatto ripetibile lasciando persistenza, segreti e orchestrazione alla piattaforma. Un database cloud gestito trasferisce maggiori responsabilità operative a un provider, sebbene non sia lo stesso prodotto o superficie di controllo di un'istanza Linux autogestita.
Non scegliere i container semplicemente perché il team dell'applicazione utilizza Kubernetes. I database hanno uno stato durevole, obiettivi di ripristino e requisiti di latenza. Al contrario, non rifiutare i contenitori perché sono effimeri: il contenitore può essere sostituibile mentre i dati, i log, i backup e la configurazione vengono persistenti correttamente. La decisione dovrebbe basarsi sulla capacità del team, sulla standardizzazione, sui requisiti di alta disponibilità, sull'integrazione dello storage, sul processo di patch e sul grado di controllo a livello di host richiesto.
| Modello | Ideale | Onere di progettazione principale |
|---|---|---|
| Host nativo o VM | Servizio database prevedibile e di lunga durata | Ciclo di vita del sistema operativo, patch e HA host |
| Contenitore | Distribuzione ripetibile con piattaforma matura ingegneria | Archiviazione persistente, segreti, pianificazione e ripristino |
| Servizio gestito | Team che preferiscono l'infrastruttura gestita dal provider | Limiti del servizio, adattamento della migrazione e modello ricorrente |
Piattaforme Linux supportate: un elenco volutamente breve
Per un'installazione nativa di SQL Server 2025, Microsoft supporta RHEL 9 e 10 e Ubuntu 22.04 e 24.04, utilizzando XFS o ext4. RHEL 10 e Ubuntu 24.04 erano opzioni di anteprima disponibili a livello generale e sono diventate completamente supportate a partire da CU1 il 29 gennaio 2026. SUSE Linux Enterprise Server non è supportato per SQL Server 2025. Se un'istanza precedente di SQL Server è attualmente in esecuzione su SLES, l'aggiornamento dei file binari in atto non è il percorso verso il 2025; pianificare uno spostamento affiancato, normalmente eseguendo il backup e il ripristino dei database su una destinazione supportata.
La matrice di supporto è un limite tecnico, non un suggerimento. Una distribuzione che tecnicamente può installare un RPM o eseguire un processo non è automaticamente una piattaforma di produzione supportata. Aggiungi la versione principale della distribuzione scelta nel record dell'architettura e confermala confrontandola con le guide attuali per la configurazione di Linux di Microsoft. Verificare inoltre la posizione di supporto del livello di virtualizzazione, del driver di archiviazione, dello stack di clustering e dell'agente di backup. Il database può essere supportato mentre un componente circostante essenziale non lo è.
Pianificare capacità e topologia prima dell’installazione
Inizia con le prove del carico di lavoro: picchi di transazioni al secondo, sessioni simultanee, crescita del database, mix di lettura/scrittura, dimensioni del set di lavoro, query più grandi, finestre batch e obiettivi di ripristino. I requisiti minimi di installazione non descrivono un server di produzione integro. SQL Server compete per CPU, memoria e I/O con il kernel, gli agenti di sicurezza, il software di backup e il monitoraggio. Lascia un margine esplicito invece di assegnare ogni risorsa al database.
Separa la capacità dalla disponibilità. Una VM di grandi dimensioni non è altamente disponibile semplicemente perché ha molti core. Un cluster a due nodi non è resiliente se entrambi i nodi, il relativo spazio di archiviazione e il relativo quorum dipendono da un dominio di errore. Disegna le dipendenze: host di calcolo, rack o zone, DNS, identità, servizio orario, percorsi di rete, archiviazione, testimone, destinazione di backup e piano di gestione. Quindi contrassegna quali errori il progetto può tollerare e in che modo viene ripristinato dal resto.
Per SQL Server Standard, osserva il limite massimo della capacità di calcolo: un'istanza del Motore di database può utilizzare il minore tra quattro socket o 32 core. La guida alle licenze esprime anche il limite Standard come 32 core concessi in licenza. L'aggiunta di vCPU oltre il limite supportato non trasforma lo standard in Enterprise e può complicare costi e conformità. Se il carico di lavoro richiede effettivamente più elaborazione, operazioni online avanzate o funzionalità HA più ampie, confronta Enterprise prima di finalizzare la piattaforma.
Installazione nativa su RHEL o Ubuntu
Una build di produzione dovrebbe essere automatizzata, ma gli amministratori dovrebbero capire cosa fa l'automazione. Il flusso di lavoro tipico consiste nel fornire un sistema operativo supportato, applicargli una patch, configurare DNS e sincronizzazione dell'ora, montare volumi di dati, aggiungere il repository di pacchetti firmati di Microsoft, installare il pacchetto mssql-server, eseguire la configurazione iniziale, selezionare l'edizione, accettare i termini, impostare le credenziali dell'amministratore di sistema in modo sicuro e avviare il servizio systemd. Gli strumenti client come sqlcmd possono essere installati separatamente sugli host amministrativi.
Non inserire una vera password di amministratore nella cronologia della shell, nei log di cloud-init o in un repository di configurazione. Utilizza il gestore dei segreti dell'organizzazione e un processo di bootstrap controllato. Dopo la configurazione, verifica systemctl status mssql-server, esamina il log degli errori di SQL Server, connettiti localmente con crittografia ed esegui query su SERVERPROPERTY('ProductVersion'), SERVERPROPERTY('Edition') e i percorsi dei dati configurati. Applica la CU approvata prima dell'onboarding dei dati di produzione.
Sposta i dati predefiniti e le directory dei log solo attraverso una configurazione documentata di SQL Server, non improvvisando collegamenti simbolici. Imposta la proprietà e le autorizzazioni in modo restrittivo per l'account mssql. Aprire TCP 1433 solo dove richiesto; una porta predefinita esposta a un'intera rete non è un risultato della distribuzione. Definire in modo esplicito le origini del firewall, i percorsi di gestione e le stringhe di connessione dell'applicazione. Infine, registra ogni impostazione mssql-conf non predefinita nella documentazione dell'infrastruttura controllata dalla versione.
Container: ripetibile non significa dati usa e getta
Microsoft supporta immagini di contenitori SQL Server 2025 su host Linux x86-64 con processori Intel o AMD. Gli ambienti di traduzione ed emulazione come Rosetta 2, Prism e QEMU non sono testati o supportati. Aggiungi un'immagine di produzione a un tag CU approvato e preferibilmente a un digest immutabile; l'utilizzo di un tag mobile rende difficile dimostrare cosa è cambiato tra i riavvii.
Il contenitore deve essere eseguito come utente non root, ricevere il suo segreto tramite l'orchestratore o l'archivio segreto e utilizzare l'archiviazione persistente per /var/opt/mssql o un layout di dati deliberatamente separato. Convalida la classe di storage per latenza, throughput, comportamento fsync, allegato di failover e snapshot. Un volume che funziona per una cache Web potrebbe non essere adatto per un registro delle transazioni con operazioni di scrittura pesanti. Imposta richieste e limiti di CPU e memoria con headroom misurato. SQL Server 2025 comprende cgroup v2, migliorando la consapevolezza delle risorse assegnate dalle moderne piattaforme Linux e container, ma limiti scadenti producono comunque prestazioni scadenti.
I controlli di integrità dovrebbero distinguere "il processo esiste" da "il database accetta lavoro utile". Aggiungi un margine di avvio per il ripristino da arresto anomalo, evita cicli di riavvio che interrompono il ripristino e drena il traffico delle applicazioni prima della sostituzione pianificata del pod. I backup devono lasciare il dominio di errore del contenitore. Prova a ripristinarli in un'istanza pulita creata dalla stessa immagine e configurazione documentate.
Prestazioni: progettare prima il percorso di I/O
Le prestazioni del database su Linux vengono generalmente ottenute o perse a causa di una combinazione di qualità delle query, pressione della memoria e latenza di archiviazione. Dati separati, log delle transazioni, tempdb e backup in cui l'architettura di storage può fornire prestazioni o caratteristiche di errore realmente indipendenti. La semplice creazione di quattro directory sullo stesso dispositivo saturo garantisce ordine organizzativo, non quattro percorsi I/O. Misura la latenza di lettura e scrittura a livello di SQL Server e del sistema operativo, anche durante i picchi di backup, checkpoint e manutenzione.
Imposta la memoria massima del server SQL Server in modo che il sistema operativo, i driver e gli agenti mantengano memoria sufficiente. Fai attenzione allo scambio e alla pressione prolungata della memoria piuttosto che fare affidamento su un singolo numero di memoria libera. Allinea la topologia vCPU e la progettazione NUMA con l'hypervisor e il carico di lavoro. Le macchine virtuali eccessivamente ampie possono comportare penalità di pianificazione, mentre i sistemi sottodimensionati creano code eseguibili e latenza instabile. Utilizza le statistiche di attesa effettive, l'archivio query e i piani di esecuzione per distinguere i problemi di CPU, I/O, blocco, concessione di memoria e progettazione delle query.
SQL Server 2025 supporta l'inserimento di tempdb in tmpfs. Ciò può essere utile per carichi di lavoro temporanei adeguati poiché tmpfs è supportato dalla memoria, ma è volatile, consuma memoria e può aumentare la pressione altrove. In questa disposizione è supportato solo tempdb; non collocare mai lì database utente o database di sistema persistenti. Dimensionarlo in modo conservativo, impostare deliberatamente la crescita dei file, tenere conto del comportamento di riavvio e testare il caricamento dello scenario peggiore di fuoriuscita o di archivio di versioni. Le guida alla configurazione di tmpfs di Microsoft devono essere seguite esattamente.
La manutenzione rimane specifica del carico di lavoro. Aggiorna le statistiche con la cadenza appropriata, gestisci l'integrità dell'indice in base ai vantaggi misurati, mantieni utile la fidelizzazione del Query Store e rivedi i piani costosi dopo gli aggiornamenti. La connettività ODBC generica per PolyBase espande le opzioni delle origini dati esterne su Linux, ma le scansioni remote dipendono ancora dalla qualità del driver, dalla latenza di rete, dal pushdown dei predicati e dalla capacità dell'origine. Considera la federazione come un progetto di integrazione, non come spazio di archiviazione locale gratuito.
Sicurezza: usare Linux senza creare punti ciechi
SQL Server 2025 su Linux abilita TLS 1.3 per impostazione predefinita. Si tratta di una linea di base solida, ma la crittografia non è completa finché i client non convalidano il certificato del server e gli amministratori non controllano l'attendibilità. Utilizza un certificato emesso per il nome del servizio, proteggi la sua chiave privata, automatizza il rinnovo in modo sicuro e testa i driver meno recenti prima dell'applicazione delle modifiche. Evita di risolvere gli errori dei certificati impostando ogni client in modo che consideri attendibile qualsiasi certificato del server.
Preferisci identità gestite centralmente laddove l'architettura dell'applicazione le supporta, utilizza identità di servizio separate e concedi i diritti minimi del database. SQL Server 2025 aggiunge criteri password personalizzati per gli accessi SQL, utili quando non è possibile rimuovere l'autenticazione SQL. Una politica dovrebbe definire durata, complessità, cronologia, blocco e rotazione in linea con il modello di rischio dell'organizzazione; non dovrebbe incoraggiare variazioni mensili prevedibili della password. Mantieni l'accesso amministrativo di emergenza protetto, controllato e testato.
A livello host, riduci al minimo i pacchetti installati, limita l'accesso interattivo, mantieni ristretta l'appartenenza a sudo, applica le autorizzazioni dei file e monitora le modifiche alla configurazione e ai certificati. Utilizza liste consentite firewall tra applicazioni, amministratori, nodi cluster e sistemi di monitoraggio. Mantieni SELinux o i controlli obbligatori della distribuzione nella configurazione supportata anziché disabilitare la protezione per far "funzionare" un'installazione. Invia informazioni di controllo SQL, errori di autenticazione, eventi di sistema e registri di sicurezza dell'host a una piattaforma centrale con conservazione adeguata all'azienda.
Le patch appartengono alla sicurezza e all'affidabilità. Mantenere un ciclo ricorrente per il kernel Linux, SQL Server CU, i driver, gli strumenti da riga di comando, il software di backup e l'immagine di base del contenitore. Definisci quali aggiornamenti richiedono il riavvio o il failover, chi convalida il servizio in seguito e quali prove chiudono la modifica. La scansione delle vulnerabilità dovrebbe comprendere la differenza tra un livello di immagine, un pacchetto installato e un processo di database in esecuzione con patch.
Alta disponibilità: definire il guasto da gestire
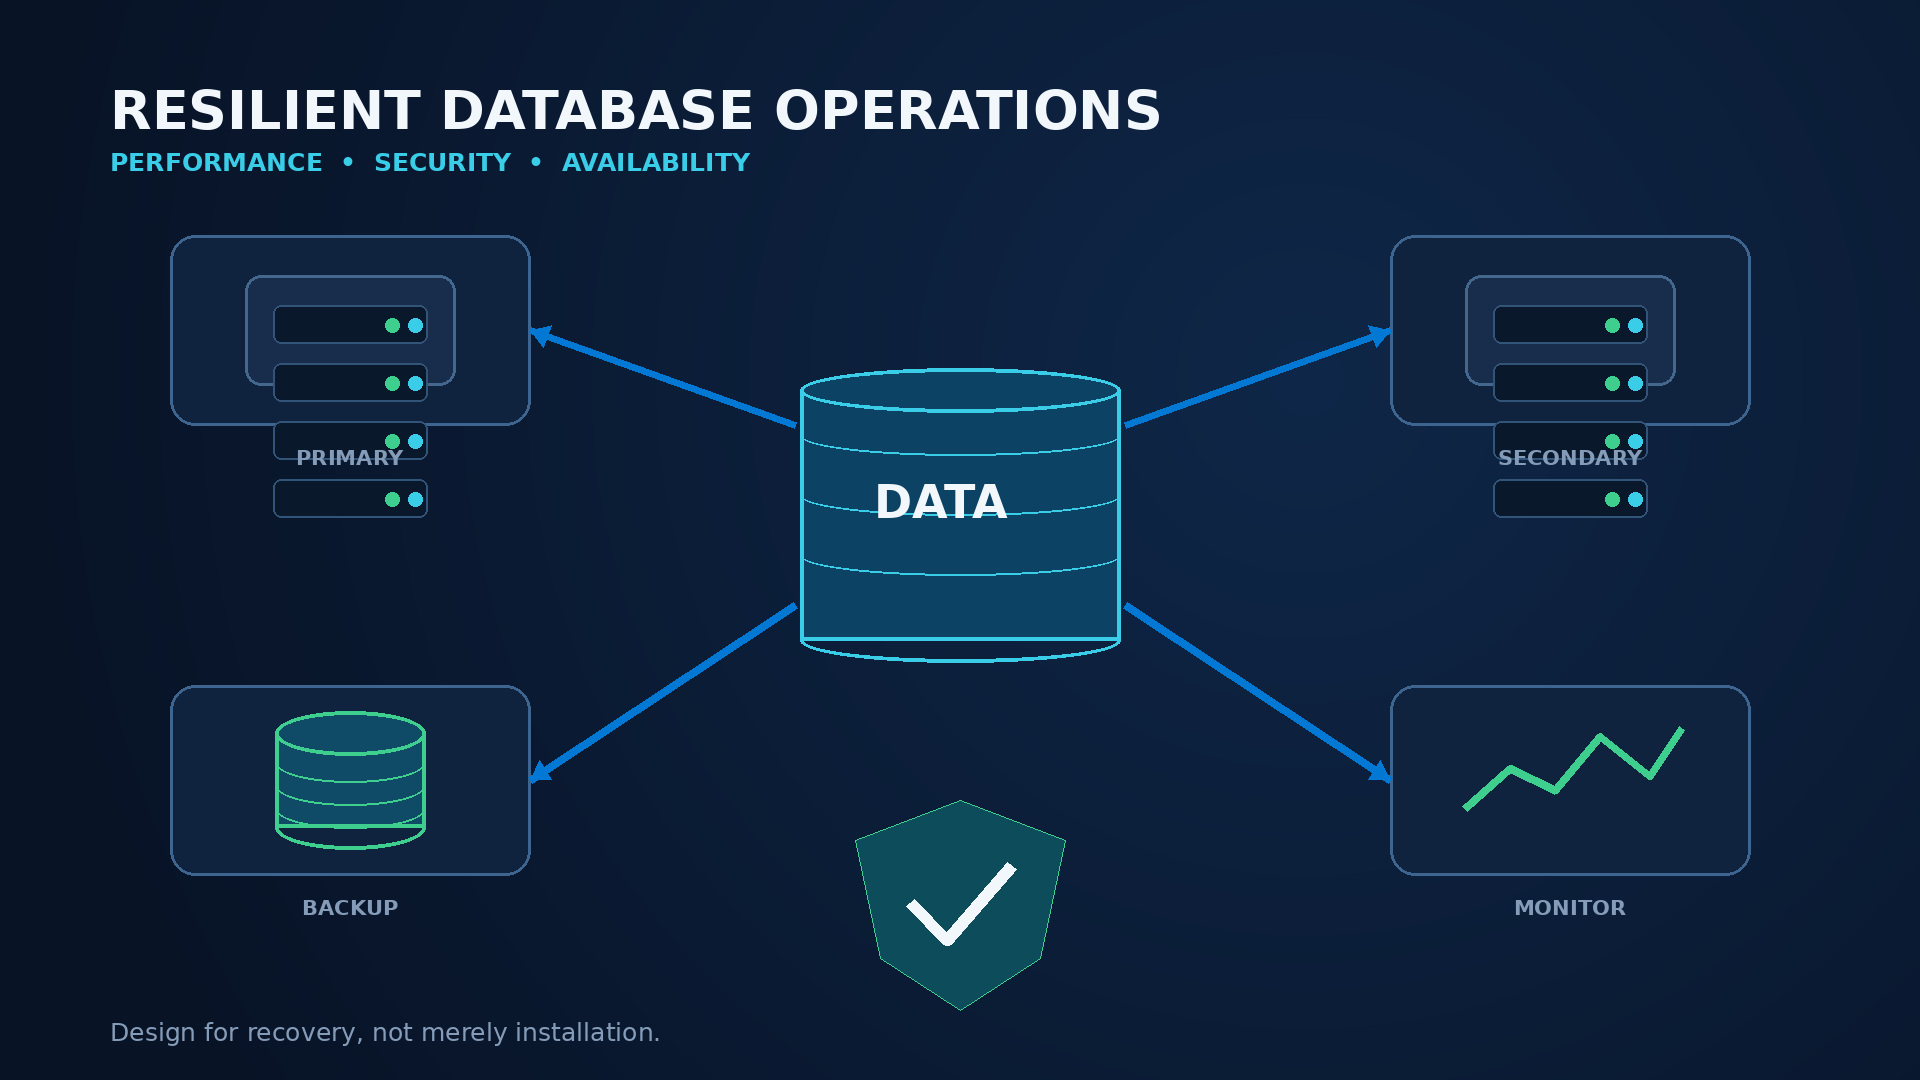
SQL Server su Linux supporta istanze di cluster di failover e gruppi di disponibilità con orchestrazione basata su Pacemaker, ma risolvono problemi diversi. Una FCI protegge un'istanza e normalmente dipende dallo spazio di archiviazione condiviso. Un gruppo di disponibilità replica i database utente selezionati tra repliche e può fornire copie leggibili o di ripristino di emergenza a seconda dell'edizione e della configurazione. Nessuno dei due sostituisce i backup e non protegge un'applicazione se DNS, identità, quorum o un percorso di rete condiviso rimangono un singolo punto di errore.
Scrivi prima gli obiettivi di ripristino. RTO descrive la rapidità con cui il servizio dovrebbe ritornare; L'RPO descrive la quantità di perdita di dati commessa accettabile. La replica sincrona può ridurre la perdita di dati nell'ambito dell'errore previsto, ma aggiunge latenza e richiede comunque una policy di failover corretta. La replica asincrona è spesso migliore per i siti di disaster recovery distanti, accettando una potenziale lacuna di dati. Documenta se il failover è automatico o manuale, quali database vengono spostati insieme, come vengono sincronizzati gli accessi e i processi e come le applicazioni rilevano il nuovo primario.
Pacemaker necessita di quorum, fencing e agenti di risorse testati. La recinzione non è una decorazione opzionale: impedisce a due nodi di credere di possedere lo stesso servizio o deposito. Posiziona nodi e testimoni in domini di errore significativi, mantieni il tempo sincronizzato e prova la perdita di un nodo, segmento di rete, percorso di archiviazione e testimone. L'edizione Standard ha funzionalità di gruppo di disponibilità più ristrette rispetto a Enterprise, quindi verificare i limiti esatti delle funzionalità prima di promettere una topologia. La panoramica del gruppo di disponibilità Linux di Microsoft è un punto di partenza, non un sostituto di un runbook.
Backup: il vero prodotto è il ripristino
Un processo di backup che riporta il successo è solo un input per la recuperabilità. Definire pianificazioni complete, differenziali e del registro delle transazioni dall'RPO; scegliere la fidelizzazione tra esigenze operative, contrattuali e normative; crittografare i backup; e archiviare copie all'esterno dell'host del database e all'esterno del dominio di errore primario. Proteggi le credenziali di backup separatamente dalle credenziali dell'amministratore del database in modo che un compromesso non cancelli sia le copie di produzione che quelle di ripristino.
Utilizza backup nativi di SQL Server per un ripristino coerente con il database. Gli snapshot dell'infrastruttura possono integrarli se coordinati e supportati, ma un'immagine del disco coerente con i crash non sostituisce automaticamente una catena di backup del database testata. Monitora l'età, la durata, il throughput e gli errori del backup. Verifica i checksum ove appropriato, esegui controlli di integrità e mantieni spazio libero sufficiente per i ripristini di emergenza.
I test di ripristino devono essere pianificati, misurati e documentati. Ripristina in un ambiente pulito, ripristina in un momento prescelto, esegui controlli di integrità, verifica gli utenti e l'accesso alle applicazioni e confronta l'RTO raggiunto con l'obiettivo. Testa anche la chiave di backup crittografata e il ripristino del certificato. La guida al backup e ripristino di Microsoft per Linux illustra i meccanismi supportati; l'organizzazione deve aggiungere proprietà, conservazione e prove.
Monitoraggio: correlare i segnali di SQL Server e Linux
Monitorare dalla transazione dell'utente verso il basso. Gli indicatori del livello di servizio potrebbero includere richieste riuscite, latenza e tasso di errore. I segnali di SQL Server includono attese, blocchi, deadlock, compilazioni, regressioni di Query Store, utilizzo dei log, stato del database, code AG, durata del backup ed errori dei processi. I segnali Linux includono pressione della CPU, coda di esecuzione, pressione della memoria, scambio, capacità del file system, latenza I/O, errori di rete e riavvii di sistema. Le distribuzioni dei contenitori aggiungono eventi di limitazione, eliminazione, volume ed pianificazione.
Utilizza linee di base anziché soglie universali. L'80% della CPU può essere salutare per un server batch e disastroso per un servizio sensibile alla latenza senza spazio di burst. Avvisa sulle condizioni durature e sull'impatto sull'utente, sopprimi i rumori di manutenzione noti e rendi ogni pagina utilizzabile. I cruscotti senza proprietà diventano decorazioni murali. Ogni avviso critico richiede un primo passaggio diagnostico, un percorso di escalation e un collegamento al runbook pertinente.
Centralizza il log degli errori di SQL Server e le voci del journal pertinenti, ma non raccogliere indiscriminatamente segreti o testi completi di query riservate. Mantieni il tempo sincronizzato in modo che gli eventi possano essere correlati tra applicazioni, proxy, SQL Server, Pacemaker e storage. Rivedi il monitoraggio dopo ogni incidente: se i soccorritori hanno dovuto inventare una query o un comando sotto pressione, aggiungilo al dashboard o al runbook.
Migrare a SQL Server 2025 su Linux
Una migrazione affiancata è solitamente più sicura che considerare una modifica del sistema operativo come un aggiornamento di routine sul posto. Database di inventario, livelli di compatibilità, regole di confronto, processi di SQL Agent, server collegati, componenti CLR, percorsi di file, certificati, credenziali, replica, origini dati esterne, driver e script operativi. Identifica le dipendenze di Windows come lettere di unità, account Windows locali, presupposti di file senza distinzione tra maiuscole e minuscole, processi solo di PowerShell o componenti non supportati. Classifica ogni elemento come portatile, sostituibile, con richiesta di riprogettazione o candidato al pensionamento.
Utilizza tempestivamente un ripristino di prova rappresentativo sulla destinazione. Esegui controlli di coerenza del database, consulenti di aggiornamento ove applicabile, test delle applicazioni e linee di base delle prestazioni. Mantenere inizialmente il livello di compatibilità originale se ciò riduce la modifica, quindi valutare il comportamento dell'ottimizzatore 2025 con prove di Query Store. Convalida attentamente le regole di confronto e il comportamento dei casi: i percorsi Linux fanno distinzione tra maiuscole e minuscole anche quando le regole di confronto del database non lo fanno.
Per database di piccole dimensioni con un'interruzione accettabile, il backup, la copia, il ripristino e il reindirizzamento potrebbero essere sufficienti. Le migrazioni più grandi o con tempi di inattività ridotti possono utilizzare modelli di distribuzione dei log, gruppi di disponibilità, replica o altri metodi di spostamento dei dati supportati, a seconda della versione e dell'edizione di origine. Ogni approccio necessita di un piano di transizione con blocco della scrittura, sincronizzazione finale, convalida, modifica della stringa di connessione, approvazione aziendale e limite di rollback. Non smantellare l'origine finché i backup, l'osservabilità e un periodo operativo stabile non confermano il nuovo servizio.
Concedere in licenza SQL Server 2025 Standard responsabilmente
Inizia separando la selezione dell'edizione, i limiti tecnici e i diritti di licenza. Lo standard può essere una buona soluzione per molti carichi di lavoro dipartimentali e di medie dimensioni, ma il limite massimo di calcolo di 32 core per istanza e i limiti delle funzionalità devono adattarsi al progetto. Microsoft offre diversi modelli di licenza e regole di virtualizzazione; il calcolo corretto dipende dai core fisici, dalle macchine virtuali, dal modello di accesso e dai diritti allegati alla licenza. Consulta le attuali linee guida sulla licenza di Microsoft SQL Server e i termini del prodotto per la decisione finale.
Licendi offre una legittima licenza di seconda mano per SQL Server 2025 Standard per le organizzazioni che cercano un percorso di licenza perpetua. Una revisione responsabile dell'acquisto dovrebbe preservare la fattura, la descrizione del prodotto, la documentazione di licenza e le prove di trasferimento/provenienza fornite per la transazione. Conferma che la quantità, l'edizione, la metrica e la topologia di distribuzione corrispondano al progetto tecnico prima dell'acquisto e ancora prima dell'attivazione della produzione.
La licenza di seconda mano può essere un'opzione di approvvigionamento valida nelle giurisdizioni pertinenti, ma non è un motivo per indovinare. Cluster complessi, accordi di hosting, mobilità cloud, frequenti spostamenti di VM o ambienti misti fisici/virtuali meritano una revisione specialistica. Conserva i record delle licenze con l'inventario delle configurazioni in modo che le modifiche all'infrastruttura attivino un controllo di conformità anziché fare affidamento su un foglio di calcolo scoperto durante un controllo.
Checklist pratica di deployment
Architettura e supporto
- Registra il proprietario dell'azienda, il proprietario tecnico, la classificazione dei dati, RTO e RPO.
- Seleziona host nativo, VM o contenitore in base alle operazioni e al ripristino, non alla moda.
- Scegli RHEL 9/10 o Ubuntu 22.04/24.04 e XFS o ext4.
- Registra l'edizione di SQL Server, la build CU, la build del sistema operativo, il kernel e il digest dell'immagine.
- Conferma ogni driver critico, sono supportati l'estensione, il componente cluster e l'agente di backup.
- Verificare che il limite massimo di elaborazione a 32 core di Standard sia adatto all'istanza.
Build e sicurezza
- Automatizza la configurazione del repository, l'installazione dei pacchetti e le impostazioni approvate.
- Recupera i segreti da un deposito; tienili lontani da script, immagini e cronologia della shell.
- Installa un certificato di servizio e testa TLS 1.3 con i driver client di produzione.
- Limita le regole del firewall, sudo, la proprietà dei file e l'accesso interattivo.
- Abilita il controllo richiesto e inoltra centralmente gli eventi di sicurezza del database e dell'host.
- Documenta il ciclo ricorrente di patch di sistema operativo, CU, driver e immagine contenitore.
Prestazioni e dati
- Dimensioni derivanti dal carico di lavoro misurato, crescita e picchi di manutenzione.
- Riservare memoria e margine della CPU per Linux e agenti operativi.
- Convalidare la latenza e la durabilità di dati, registro, tempdb e spazio di archiviazione di backup.
- Impostare deliberatamente la memoria massima del server e la crescita dei file.
- Utilizzare tmpfs solo per tempdb, con una capacità testata e un piano di riavvio.
- Catturare un Query Store di pre-produzione e linea di base del sistema operativo.
Disponibilità e ripristino
- Mappatura dei domini di errore e rimozione delle dipendenze condivise accidentali.
- Configura quorum, fencing, listener/DNS e policy di failover in modo esplicito.
- Testare scenari di errore di nodo, rete, archiviazione, testimone e replica.
- Crittografare i backup e conservare le copie all'esterno del dominio di errore primario.
- Eseguire e cronometrare un ripristino pulito, incluse chiavi e ripristino point-in-time.
- Scrivi runbook di riconnessione, failover, escalation e rollback dell'applicazione.
Operazioni e licenze
- Avviso su impatto utente, attese SQL, blocco, capacità, integrità AG ed età del backup.
- Correla SQL, systemd, sistema operativo, contenitore, cluster e telemetria di archiviazione.
- Assegna un proprietario e la prima azione a ogni elemento critico avviso.
- Inventaria processi, accessi, certificati, driver e dipendenze prima della migrazione.
- Convalida modello di licenza, metrica, quantità, prove e topologia.
- Pianifica la revisione post-lancio di prestazioni, sicurezza, ripristino e conformità.
Conclusione
SQL Server 2025 su Linux ottiene maggiori risultati quando viene utilizzato come servizio di database, non semplicemente installato come un altro pacchetto. Piattaforme supportate, una base di CU precisa, storage durevole, controlli accurati delle risorse, convalida dei certificati, ripristino provato e monitoraggio utile sono tutti parti dello stesso progetto. Linux offre ai team solide basi di automazione e osservabilità; SQL Server aggiunge le proprie responsabilità in termini di stato, transazione e licenza.
Crea il modello operativo prima del server di produzione, testa i percorsi di errore prima di promettere la disponibilità e collega l'acquisizione delle licenze alla topologia effettiva. Questa disciplina produce una piattaforma più semplice da applicare con patch, spiegare, ripristinare e controllare e offre a SQL Server 2025 una posizione stabile in un ambiente Linux-first.
Domande frequenti
Quali distribuzioni Linux supportano SQL Server 2025?
Microsoft supporta installazioni native su RHEL 9 e 10 e Ubuntu 22.04 e 24.04, utilizzando XFS o ext4. RHEL 10 e Ubuntu 24.04 sono completamente supportati da CU1.
SQL Server 2025 supporta SLES?
No. SLES non è una piattaforma SQL Server 2025 supportata. Migrare un'istanza precedente ospitata da SLES a una destinazione RHEL o Ubuntu supportata, normalmente tramite un piano di backup e ripristino affiancato.
Qual è l'ultimo aggiornamento Linux di SQL Server 2025?
Al 31 luglio 2026, è CU7, build 17.0.4065.4, rilasciato il 16 luglio 2026. Ricontrolla sempre le note di rilascio prima distribuzione.
È possibile eseguire SQL Server 2025 in un contenitore Linux?
Sì, su host Linux x86-64 supportati che utilizzano processori Intel o AMD. Conserva l'archiviazione del database, blocca la versione dell'immagine, proteggi i segreti e testa il backup e il ripristino all'esterno del contenitore.
Posso inserire i database SQL Server su tmpfs?
Solo tempdb è supportato su tmpfs. È volatile e supportato dalla memoria, quindi dimensionalo e testalo attentamente. I database utente e i database di sistema persistenti devono rimanere su uno spazio di archiviazione supportato e duraturo.
L'edizione Standard utilizza più di 32 core?
Un'istanza del Motore di database Standard è limitata al minore tra quattro socket o 32 core. Le regole di licenza e virtualizzazione devono ancora essere verificate per la distribuzione effettiva.
I gruppi di disponibilità sostituiscono i backup?
No. La replica può migliorare la disponibilità, ma può anche riprodurre eliminazioni o danneggiamenti. Mantieni backup crittografati indipendenti ed esegui test di ripristino pianificati.
Una licenza SQL Server di seconda mano è legittima?
Può essere un percorso di approvvigionamento legittimo laddove siano soddisfatte le condizioni legali e di trasferimento della licenza. Conserva i documenti di transazione e provenienza e convalida edizione, metrica e topologia per la distribuzione prevista.




