 FR
 EN
 DE
 IT
 PT
 ES


SQL Server 2025 sous Linux : guide pratique de déploiement
Exécuter SQL Server sous Linux n'est plus une voie secondaire expérimentale. Pour les organisations qui standardisent déjà Red Hat Enterprise Linux ou Ubuntu, SQL Server 2025 permet de conserver les outils de base de données familiers tout en intégrant le moteur dans un modèle d'exploitation Linux établi. L’attrait n’est pas simplement d’éviter Windows. Il s'agit de la capacité d'utiliser les mêmes compétences en matière d'automatisation, d'observabilité, de plates-formes de conteneurs, de contrôles de sécurité et d'infrastructure qui prennent déjà en charge le reste du parc d'applications.
Cette flexibilité ne supprime pas les décisions architecturales. Un déploiement de production fiable dépend toujours du choix d'une distribution prise en charge, de l'application de la bonne mise à jour cumulative, du dimensionnement délibéré du stockage et de la mémoire, de la protection des secrets, des tests de récupération et de l'adaptation de la topologie à l'édition et à la licence appropriées. Ce guide suit ce chemin depuis la première réunion de conception jusqu'à la liste de contrôle opérationnelle.
Commencez par une version de référence précise
SQL Server 2025, la génération 17.x, est devenue généralement disponible le 18 novembre 2025. Depuis le 31 juillet 2026, la dernière mise à jour cumulative est CU7, publiée le 16 juillet 2026, avec le numéro de build 17.0.4065.4. Ces dates sont importantes car « SQL Server 2025 » ne constitue pas une référence de production suffisamment précise. Les enregistrements d'installation, la gestion de la configuration et les rapports d'incident doivent nommer l'édition, la build, la distribution Linux, le noyau et le résumé de l'image du conteneur, le cas échéant.
Les mises à jour cumulatives de Microsoft sont cumulatives : une nouvelle installation peut normalement être déplacée directement vers la CU actuelle plutôt que d'appliquer tous les packages précédents. Néanmoins, une mise à jour doit d’abord passer par un environnement représentatif hors production. Testez la connectivité des applications, les tâches de l'agent SQL, la sauvegarde et la restauration, le comportement des groupes de disponibilité, les extensions, les pilotes et la surveillance. Conservez un itinéraire de restauration ou de récupération convenu. Les notes de version officielles de SQL Server 2025 Linux sont le bon endroit pour confirmer les versions actuelles et les problèmes connus avant une fenêtre de maintenance.
Choisissez le modèle d’exploitation avant les commandes
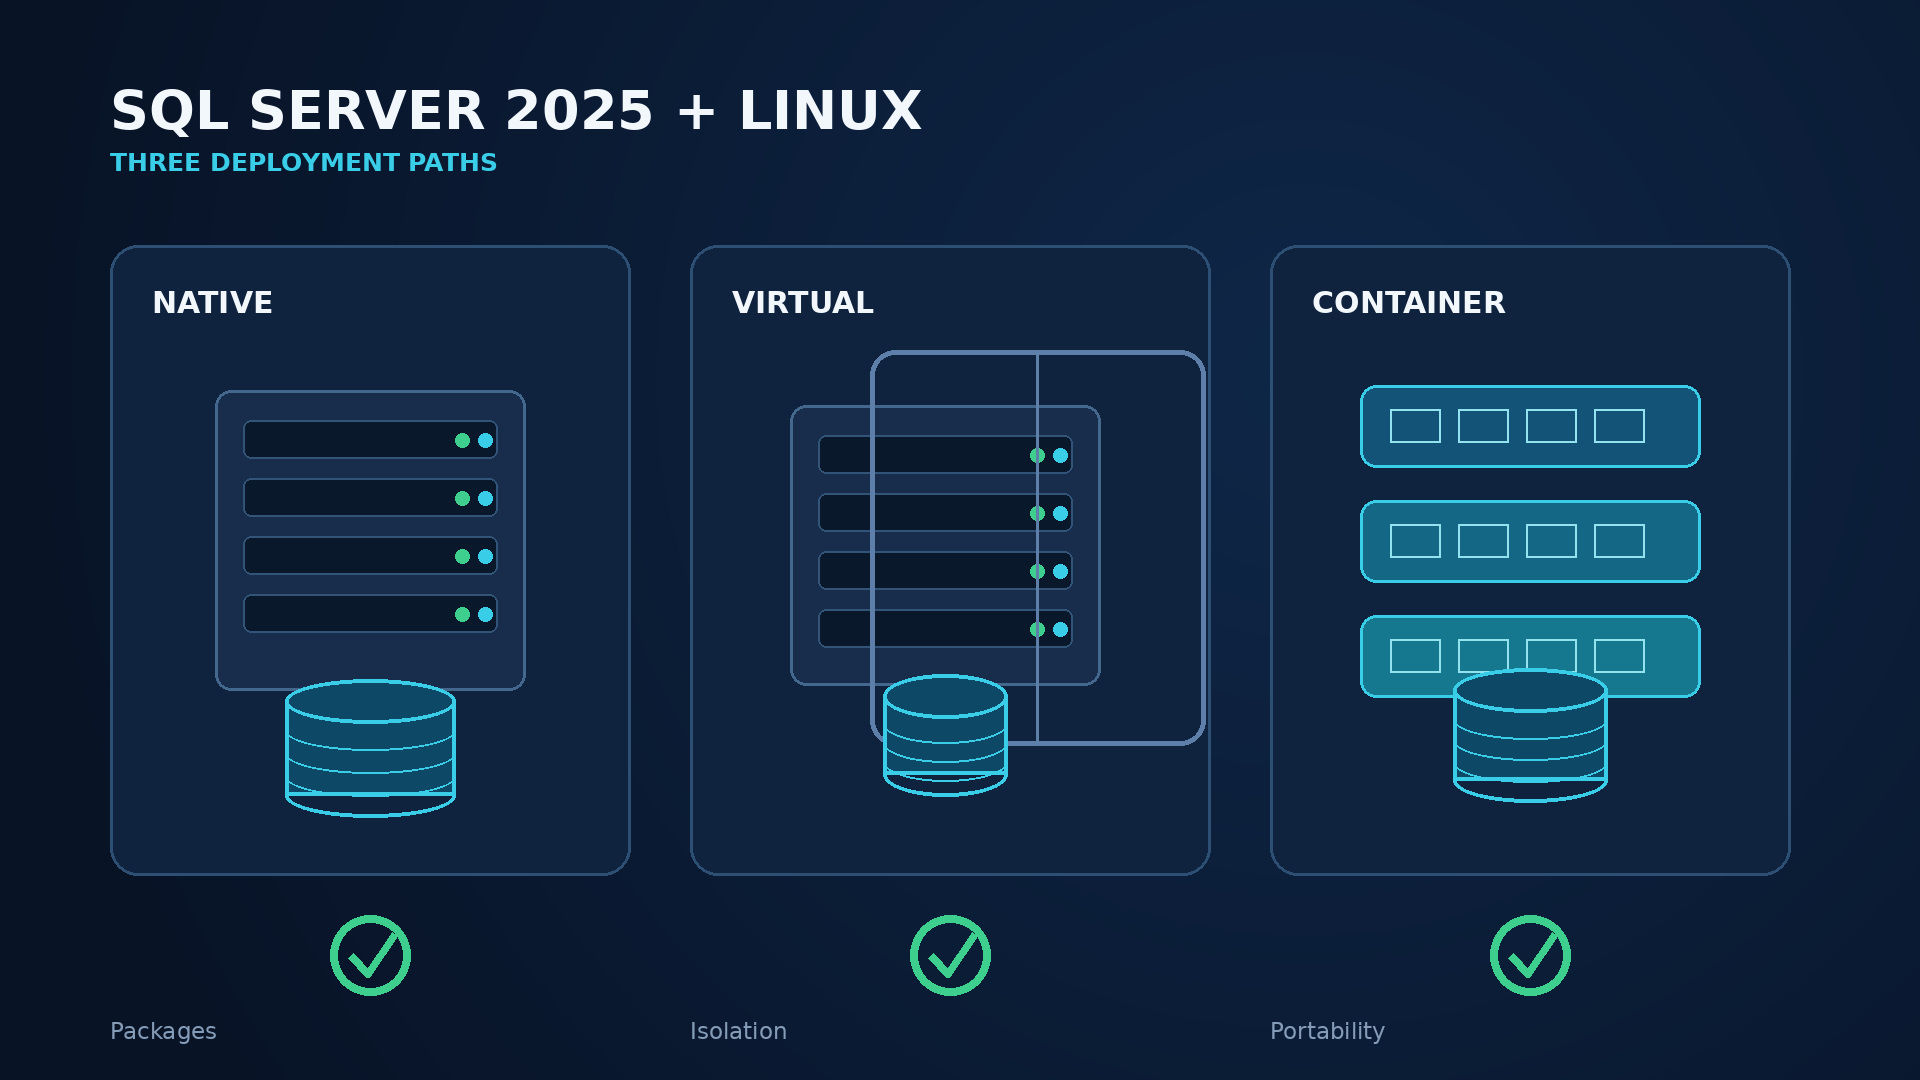
Il existe quatre modèles courants. Une installation de package natif place SQL Server directement sur un serveur Linux ou une machine virtuelle pris en charge. Il offre une intégration systemd simple et constitue souvent le choix le plus évident pour les hôtes de bases de données stables et de longue durée. Une machine virtuelle ajoute une isolation de l'infrastructure, des instantanés pour les flux de travail de l'infrastructure et des options de récupération après sinistre familières, mais la base de données a toujours besoin d'une sauvegarde et d'une restauration compatibles SQL. Un conteneur regroupe le moteur et les dépendances dans un artefact reproductible tout en laissant la persistance, les secrets et l'orchestration à la plateforme. Une base de données cloud gérée transfère davantage de responsabilités opérationnelles à un fournisseur, même s'il ne s'agit pas du même produit ou de la même surface de contrôle qu'une instance Linux autogérée.
| Modèle | Meilleur ajustement | Fardeau de conception principal |
|---|---|---|
| Hôte natif ou VM | Service de base de données prévisible et de longue durée | Cycle de vie du système d'exploitation, correctifs et haute disponibilité de l'hôte |
| Conteneur | Déploiement reproductible avec une plate-forme mature ingénierie | Stockage persistant, secrets, planification et récupération |
| Service géré | Équipes qui préfèrent une infrastructure exploitée par un fournisseur | Contraintes de service, ajustement de la migration et modèle récurrent |
Plateformes Linux prises en charge : une liste volontairement courte
Pour une installation native de SQL Server 2025, Microsoft prend en charge RHEL 9 et 10 et Ubuntu 22.04 et 24.04, en utilisant XFS ou ext4. RHEL 10 et Ubuntu 24.04 étaient des options de préversion en disponibilité générale et sont devenus entièrement pris en charge à partir de CU1 le 29 janvier 2026. SUSE Linux Enterprise Server n'est pas pris en charge pour SQL Server 2025. Si une ancienne instance de SQL Server s'exécute actuellement sur SLES, la mise à niveau des binaires en place n'est pas la voie vers 2025 ; planifiez un déplacement côte à côte, normalement en sauvegardant et en restaurant les bases de données vers une cible prise en charge.
La matrice de support est une limite technique, pas une suggestion. Une distribution qui peut techniquement installer un RPM ou exécuter un processus n'est pas automatiquement une plate-forme de production prise en charge. Épinglez la version de distribution majeure choisie dans l'enregistrement d'architecture et confirmez-la par rapport aux guides de configuration Linux actuels. Vérifiez également la position de prise en charge de la couche de virtualisation, du pilote de stockage, de la pile de clustering et de l'agent de sauvegarde. La base de données peut être prise en charge alors qu'un composant environnant essentiel ne l'est pas.
Planifiez la capacité et la topologie avant l’installation
Commencez par des preuves de charge de travail : pic de transactions par seconde, sessions simultanées, croissance de la base de données, combinaison lecture/écriture, taille de l'ensemble de travail, requêtes les plus importantes, fenêtres de lots et objectifs de récupération. La configuration minimale requise pour l'installation ne décrit pas un serveur de production sain. SQL Server est en concurrence pour le processeur, la mémoire et les E/S avec le noyau, les agents de sécurité, les logiciels de sauvegarde et la surveillance. Laissez une marge explicite au lieu d'attribuer chaque ressource à la base de données.
Pour SQL Server Standard, respectez le plafond de capacité de calcul : une instance du moteur de base de données peut utiliser le moindre de quatre sockets ou 32 cœurs. Le guide de licence exprime également la limite standard à 32 cœurs sous licence. L’ajout de processeurs virtuels au-delà de la limite prise en charge ne transforme pas Standard en Enterprise et peut compliquer les coûts et la conformité. Si la charge de travail nécessite réellement plus de calcul, des opérations en ligne avancées ou des capacités de haute disponibilité plus larges, comparez Enterprise avant de finaliser la plate-forme.
Installation native sur RHEL ou Ubuntu
Une version de production doit être automatisée, mais les administrateurs doivent comprendre ce que fait l'automatisation. Le flux de travail typique consiste à provisionner un système d'exploitation pris en charge, à le corriger, à configurer le DNS et la synchronisation de l'heure, à monter des volumes de données, à ajouter le référentiel de packages signés de Microsoft, à installer le package mssql-server, à exécuter la configuration initiale, à sélectionner l'édition, à accepter les conditions, à définir les informations d'identification de l'administrateur système en toute sécurité et à démarrer le service systemd. Les outils clients tels que sqlcmd peuvent être installés séparément sur les hôtes administratifs.
Ne placez pas de véritable mot de passe administrateur dans l'historique du shell, les journaux d'initialisation du cloud ou un référentiel de configuration. Utilisez le gestionnaire de secrets de l'organisation et un processus d'amorçage contrôlé. Après la configuration, vérifiez le systemctl status mssql-server, consultez le journal des erreurs SQL Server, connectez-vous localement avec le cryptage et interrogez SERVERPROPERTY('ProductVersion'), SERVERPROPERTY('Edition') et les chemins de données configurés. Appliquez la CU approuvée avant d'intégrer les données de production.
Conteneurs : répétable ne veut pas dire données jetables
Microsoft prend en charge les images de conteneurs SQL Server 2025 sur les hôtes Linux x86-64 équipés de processeurs Intel ou AMD. Les environnements de traduction et d'émulation tels que Rosetta 2, Prism et QEMU ne sont ni testés ni pris en charge. Épinglez une image de production sur une balise CU approuvée et de préférence un résumé immuable ; l'utilisation d'une balise flottante rend difficile la preuve de ce qui a changé entre les redémarrages.
Le conteneur doit s'exécuter en tant qu'utilisateur non root, recevoir son secret via l'orchestrateur ou le magasin de secrets et utiliser un stockage persistant pour /var/opt/mssql ou une présentation de données délibérément séparée. Validez la classe de stockage pour la latence, le débit, le comportement fsync, la pièce jointe de basculement et les instantanés. Un volume qui fonctionne pour un cache Web peut ne pas convenir à un journal de transactions nécessitant beaucoup d'écritures. Définissez les demandes et les limites du processeur et de la mémoire avec une marge mesurée. SQL Server 2025 comprend le groupe de contrôle v2, améliorant ainsi la connaissance des ressources attribuées par les plates-formes Linux et de conteneurs modernes, mais de faibles limites produisent toujours des performances médiocres.
Les contrôles d'état doivent distinguer « le processus existe » de « la base de données accepte un travail utile ». Ajoutez une allocation de démarrage pour la récupération après incident, évitez les boucles de redémarrage qui interrompent la récupération et drainez le trafic des applications avant le remplacement prévu du pod. Les sauvegardes doivent quitter le domaine de défaillance du conteneur. Testez leur restauration sur une instance propre construite à partir de la même image et configuration documentées.
Performances : concevez d’abord le chemin d’E/S
Les performances des bases de données sous Linux sont généralement gagnées ou perdues grâce à une combinaison de qualité des requêtes, de pression de la mémoire et de latence de stockage. Séparez les données, les journaux de transactions, tempdb et les sauvegardes où l'architecture de stockage peut fournir des caractéristiques de performances ou de défaillance véritablement indépendantes. La simple création de quatre répertoires sur le même périphérique saturé assure la propreté de l'organisation, et non quatre chemins d'E/S. Mesurez la latence de lecture et d'écriture au niveau des couches SQL Server et du système d'exploitation, y compris pendant les pics de sauvegarde, de point de contrôle et de maintenance.
Définissez la mémoire maximale du serveur SQL Server afin que le système d'exploitation, les pilotes et les agents conservent suffisamment de mémoire. Surveillez les échanges et la pression soutenue de la mémoire plutôt que de compter sur un seul numéro de mémoire libre. Alignez la topologie du vCPU et la conception NUMA avec l'hyperviseur et la charge de travail. Les machines virtuelles trop volumineuses peuvent entraîner des pénalités de planification, tandis que les systèmes sous-dimensionnés créent des files d'attente exécutables et une latence instable. Utilisez les statistiques d'attente réelles, le magasin de requêtes et les plans d'exécution pour distinguer les problèmes de processeur, d'E/S, de verrouillage, d'allocation de mémoire et de conception de requêtes.
SQL Server 2025 prend en charge le placement de tempdb sur tmpfs. Cela peut être utile pour les charges de travail temporaires appropriées, car tmpfs est sauvegardé en mémoire, mais il est volatil, consomme de la mémoire et peut augmenter la pression ailleurs. Seul tempdb est pris en charge dans cet arrangement ; n’y placez jamais de bases de données utilisateur ou de bases de données système persistantes. Dimensionnez-le de manière prudente, définissez délibérément la croissance des fichiers, tenez compte du comportement de redémarrage et testez en charge le pire scénario de déversement ou de stockage de versions. Les conseils de configuration tmpfs de Microsoft doivent être suivis à la lettre.
La maintenance reste spécifique à la charge de travail. Mettez à jour les statistiques à une cadence appropriée, gérez la santé des index en fonction des avantages mesurés, gardez la rétention du magasin de requêtes utile et examinez les plans coûteux après les mises à niveau. La connectivité ODBC générique pour PolyBase étend les options de sources de données externes sous Linux, mais les analyses à distance dépendent toujours de la qualité du pilote, de la latence du réseau, du refoulement des prédicats et de la capacité de la source. Traitez la fédération comme une conception d'intégration, et non comme un stockage local gratuit.
Sécurité : exploitez Linux sans créer d’angles morts
SQL Server 2025 sur Linux active TLS 1.3 par défaut. Il s'agit d'une base de référence solide, mais le chiffrement n'est pas complet tant que les clients n'ont pas validé le certificat du serveur et que les administrateurs n'ont pas contrôlé la confiance. Utilisez un certificat délivré pour le nom du service, protégez sa clé privée, automatisez le renouvellement en toute sécurité et testez les anciens conducteurs avant les changements d'application. Évitez de résoudre les erreurs de certificat en configurant chaque client pour qu'il fasse confiance à n'importe quel certificat de serveur.
Préférez les identités gouvernées de manière centralisée là où l'architecture de l'application les prend en charge, utilisez des identités de service distinctes et accordez les droits de base de données minimum. SQL Server 2025 ajoute des politiques de mot de passe personnalisées pour les connexions SQL, utiles lorsque l'authentification SQL ne peut pas être supprimée. Une politique doit définir la durée, la complexité, l'historique, le verrouillage et la rotation conformément au modèle de risque de l'organisation ; cela ne devrait pas encourager des variations mensuelles prévisibles des mots de passe. Conservez l'accès administratif d'urgence dans un coffre-fort, audité et testé.
Au niveau de la couche hôte, minimisez les packages installés, restreignez la connexion interactive, limitez l'adhésion à sudo, appliquez les autorisations sur les fichiers et surveillez les modifications apportées à la configuration et aux certificats. Utilisez des listes autorisées de pare-feu entre les applications, les administrateurs, les nœuds de cluster et les systèmes de surveillance. Conservez SELinux ou les contrôles obligatoires de la distribution dans la configuration prise en charge plutôt que de désactiver la protection pour faire « fonctionner » une installation. Envoyez les informations d'audit SQL, les échecs d'authentification, les événements systemd et les journaux de sécurité de l'hôte à une plate-forme centrale avec une conservation adaptée à l'entreprise.
Haute disponibilité : définissez la panne à traiter
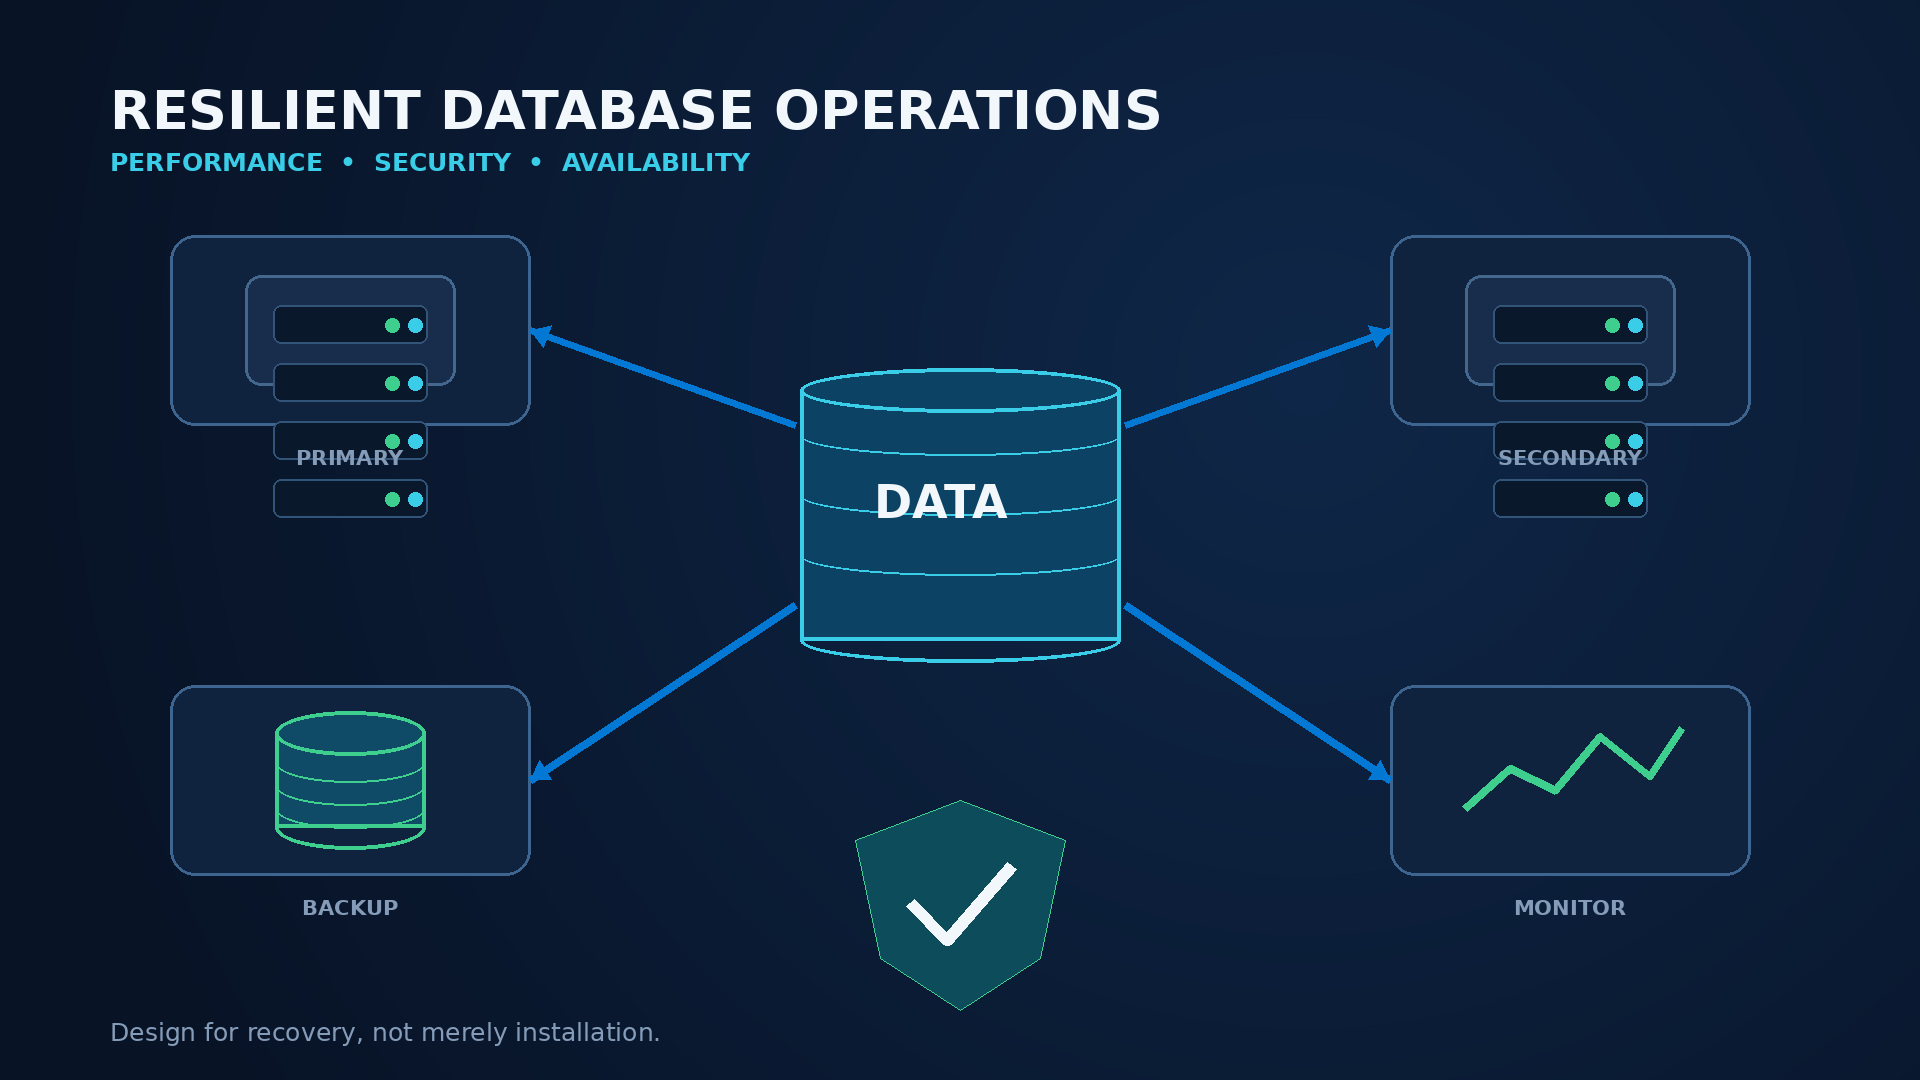
SQL Server sous Linux prend en charge les instances de cluster de basculement et les groupes de disponibilité avec une orchestration basée sur Pacemaker, mais ils résolvent des problèmes différents. Un FCI protège une instance et dépend normalement du stockage partagé. Un groupe de disponibilité réplique les bases de données utilisateur sélectionnées entre les réplicas et peut fournir des copies lisibles ou de récupération après sinistre en fonction de l'édition et de la configuration. Ni l'un ni l'autre ne remplace les sauvegardes et ni l'un ni l'autre ne protège une application si le DNS, l'identité, le quorum ou un chemin réseau partagé restent un point de défaillance unique.
Écrivez d'abord les objectifs de récupération. RTO décrit la rapidité avec laquelle le service doit revenir ; Le RPO décrit la quantité de perte de données engagée qui est acceptable. La réplication synchrone peut réduire la perte de données dans la plage de défaillance prévue, mais elle ajoute de la latence et nécessite toujours une politique de basculement correcte. La réplication asynchrone est souvent préférable pour les sites de reprise après sinistre distants, car elles acceptent une éventuelle lacune dans les données. Documentez si le basculement est automatique ou manuel, quelles bases de données se déplacent ensemble, comment les connexions et les tâches sont synchronisées et comment les applications découvrent le nouveau principal.
Pacemaker a besoin d'un quorum, d'une clôture et d'agents de ressources testés. La clôture n'est pas une décoration facultative : elle empêche deux nœuds de croire qu'ils possèdent le même service ou stockage. Placez les nœuds et les témoins dans des domaines de défaillance significatifs, gardez le temps synchronisé et répétez la perte d'un nœud, d'un segment de réseau, d'un chemin de stockage et d'un témoin. L'édition Standard offre des capacités de groupe de disponibilité plus étroites que l'édition Enterprise. Vérifiez donc les limites exactes des fonctionnalités avant de promettre une topologie. La Présentation du groupe de disponibilité Linux de Microsoft est un point de départ et ne remplace pas un runbook.
Sauvegardes : le vrai produit est la restauration
Une tâche de sauvegarde qui se termine correctement n'est qu'un apport à la récupérabilité. Définir les plannings complets, différentiels et des journaux de transactions à partir du RPO ; choisir la rétention parmi les besoins opérationnels, contractuels et réglementaires ; chiffrer les sauvegardes ; et stockez des copies en dehors de l'hôte de la base de données et en dehors du domaine de défaillance principal. Protégez les informations d'identification de sauvegarde séparément des informations d'identification de l'administrateur de base de données afin qu'une seule compromission n'efface pas les copies de production et de récupération.
Utilisez des sauvegardes SQL Server natives pour une récupération cohérente avec la base de données. Les instantanés d'infrastructure peuvent les compléter lorsqu'ils sont coordonnés et pris en charge, mais une image disque cohérente en cas de panne ne remplace pas automatiquement une chaîne de sauvegarde de base de données testée. Surveillez l’âge, la durée, le débit et les échecs des sauvegardes. Vérifiez les sommes de contrôle le cas échéant, exécutez des contrôles d'intégrité et conservez suffisamment d'espace libre pour les restaurations d'urgence.
Les tests de restauration doivent être planifiés, mesurés et documentés. Restaurez dans un environnement propre, restaurez à un moment choisi, exécutez des contrôles d'intégrité, vérifiez l'accès des utilisateurs et des applications et comparez le RTO atteint avec l'objectif. Testez également la clé de sauvegarde chiffrée et la récupération du certificat. Le Guide de sauvegarde et de restauration Microsoft pour Linux couvre les mécanismes pris en charge ; l'organisation doit ajouter la propriété, la rétention et la répétition.
Supervision : corrélez les signaux de SQL Server et de Linux
Surveiller depuis la transaction utilisateur vers le bas. Les indicateurs de niveau de service peuvent inclure les requêtes réussies, la latence et le taux d'erreur. Les signaux SQL Server incluent les attentes, les blocages, les blocages, les compilations, les régressions du magasin de requêtes, l'utilisation des journaux, l'état de la base de données, les files d'attente AG, l'âge des sauvegardes et les échecs de tâches. Les signaux Linux incluent la pression du processeur, la file d'attente d'exécution, la pression de la mémoire, l'échange, la capacité du système de fichiers, la latence d'E/S, les erreurs réseau et les redémarrages du système. Les déploiements de conteneurs ajoutent des événements de limitation, d'expulsion, de volume et de planification.
Migrer vers SQL Server 2025 sous Linux
Une migration côte à côte est généralement plus sûre que de traiter une modification du système d'exploitation comme une mise à niveau de routine sur place. Bases de données d'inventaire, niveaux de compatibilité, classements, tâches de l'agent SQL, serveurs liés, composants CLR, chemins de fichiers, certificats, informations d'identification, réplication, sources de données externes, pilotes et scripts opérationnels. Identifiez les dépendances Windows telles que les lettres de lecteur, les comptes Windows locaux, les hypothèses de fichiers insensibles à la casse, les tâches PowerShell uniquement ou les composants non pris en charge. Classez chaque élément comme portable, remplaçable, nécessitant une refonte ou candidat à la retraite.
Utilisez rapidement une restauration de test représentative sur la cible. Exécutez des vérifications de cohérence de la base de données, mettez à niveau les conseillers le cas échéant, les tests d'application et les références de performances. Conservez initialement le niveau de compatibilité d'origine si cela réduit les changements, puis évaluez le comportement de l'optimiseur 2025 avec les preuves du Query Store. Validez soigneusement le classement et le comportement de la casse : les chemins Linux sont sensibles à la casse même lorsqu'un classement de base de données ne l'est pas.
Pour les petites bases de données avec une panne acceptable, la sauvegarde, la copie, la restauration et la redirection peuvent suffire. Les migrations plus importantes ou à faible temps d'arrêt peuvent utiliser des modèles d'envoi de journaux, des groupes de disponibilité, la réplication ou d'autres méthodes de déplacement de données prises en charge, en fonction de la version et de l'édition source. Chaque approche nécessite un plan de basculement avec un gel de l'écriture, une synchronisation finale, une validation, un changement de chaîne de connexion, une approbation commerciale et une limite de restauration. Ne démontez pas la source tant que les sauvegardes, l'observabilité et une période de fonctionnement stable n'ont pas confirmé le nouveau service.
Licencier SQL Server 2025 Standard de façon responsable
Commencez par séparer la sélection de l'édition, les limites techniques et les droits de licence. Standard peut convenir à de nombreuses charges de travail départementales et de taille moyenne, mais son plafond de calcul de 32 cœurs par instance et ses limites de fonctionnalités doivent correspondre à la conception. Microsoft propose différents modèles de licence et règles de virtualisation ; le calcul correct dépend des cœurs physiques, des machines virtuelles, du modèle d'accès et des droits attachés à la licence. Consultez les Conseils actuels sur les licences Microsoft SQL Server et les conditions du produit pour prendre une décision finale.
Licendi propose une licence d’occasion légitime de SQL Server 2025 Standard pour les organisations recherchant une licence perpétuelle. Un examen d'achat responsable doit conserver la facture, la description du produit, les documents de licence et les preuves de transfert/provenance fournies pour la transaction. Confirmez que la quantité, l'édition, les mesures et la topologie de déploiement correspondent à la conception technique avant l'achat, puis à nouveau avant l'activation de la production.
Les licences d'occasion peuvent être une option d'achat valable dans les juridictions concernées, mais ce n'est pas une raison pour deviner. Les clusters complexes, les arrangements d'hébergement, la mobilité dans le cloud, les mouvements fréquents de machines virtuelles ou les domaines mixtes physiques et virtuels méritent un examen spécialisé. Conservez les enregistrements de licences avec l'inventaire de configuration afin que les modifications de l'infrastructure déclenchent une vérification de conformité plutôt que de vous fier à une feuille de calcul découverte lors d'un audit.
Liste de contrôle pratique du déploiement
Architecture et support
- Enregistrez le propriétaire de l'entreprise, le propriétaire technique, la classification des données, le RTO et le RPO.
- Sélectionnez l'hôte natif, la VM ou le conteneur en fonction des opérations et de la récupération, et non de la mode.
- Choisissez RHEL 9/10 ou Ubuntu 22.04/24.04 et XFS ou ext4.
- Enregistrez l'édition SQL Server, la version CU, la version du système d'exploitation, le noyau et le résumé d'image.
- Confirmez chaque pilote, extension, critique, le composant de cluster et l'agent de sauvegarde sont pris en charge.
- Vérifiez que le plafond de calcul de 32 cœurs de Standard correspond à l'instance.
Construction et sécurité
- Automatisez la configuration du référentiel, l'installation des packages et les paramètres approuvés.
- Récupérez les secrets d'un coffre-fort ; gardez-les à l'écart des scripts, des images et de l'historique du shell.
- Installez un certificat de service et testez TLS 1.3 avec les pilotes clients de production.
- Limitez les règles de pare-feu, sudo, la propriété des fichiers et l'accès interactif.
- Activez l'audit requis et transférez les événements de sécurité de la base de données et de l'hôte de manière centralisée.
- Documentez le cycle récurrent des correctifs du système d'exploitation, de la CU, du pilote et de l'image du conteneur.
Performances et données
- Taille à partir des pics de charge de travail, de croissance et de maintenance mesurés.
- Réservez la mémoire et la marge du processeur pour Linux et les agents opérationnels.
- Validez la latence et la durabilité des données, des journaux, de la base de données temporaire et du stockage de sauvegarde.
- Définissez délibérément la mémoire maximale du serveur et la croissance des fichiers.
- Utilisez tmpfs uniquement pour tempdb, avec une capacité et un plan de redémarrage testés.
- Capturez un magasin de requêtes de pré-production et base du système d'exploitation.
Disponibilité et restauration
- Mappez les domaines de défaillance et supprimez les dépendances partagées accidentelles.
- Configurez explicitement le quorum, le cloisonnement, l'écouteur/DNS et la politique de basculement.
- Testez les scénarios de défaillance de nœud, de réseau, de stockage, de témoin et de réplica.
- Chiffrez les sauvegardes et conservez des copies en dehors du domaine de défaillance principal.
- Effectuez et chronométrez un nettoyage. restauration, y compris les clés et la récupération à un moment précis.
- Écrire des runbooks de reconnexion, de basculement, d'escalade et de restauration des applications.
Exploitation et licences
- Alerte sur l'impact de l'utilisateur, les attentes SQL, le blocage, la capacité, l'état de santé de l'AG et l'âge de la sauvegarde.
- Corréler la télémétrie SQL, systemd, OS, conteneur, cluster et stockage.
- Attribuer un propriétaire et une première action à chaque alerte critique.
- Inventaire des tâches, des connexions, des certificats, des pilotes et des dépendances avant la migration.
- Valider le modèle de licence, les métriques, les quantités, les preuves et la topologie.
- Planifier un examen post-lancement des performances, de la sécurité, de la récupération et de la conformité.
Conclusion
SQL Server 2025 sur Linux est plus efficace lorsqu'il est utilisé comme un service de base de données, et pas simplement installé comme un autre package. Les plates-formes prises en charge, une référence de CU précise, un stockage durable, des contrôles minutieux des ressources, la validation des certificats, une récupération répétée et une surveillance utile font tous partie d'une même conception. Linux offre aux équipes de solides bases d'automatisation et d'observabilité ; SQL Server ajoute ses propres responsabilités en matière d'état, de transaction et de licence.
Questions fréquentes
Quelles distributions Linux prennent en charge SQL Server 2025 ?
Microsoft prend en charge les installations natives sur RHEL 9 et 10 et Ubuntu 22.04 et 24.04, en utilisant XFS ou ext4. RHEL 10 et Ubuntu 24.04 sont entièrement pris en charge à partir de CU1.
SQL Server 2025 prend-il en charge SLES ?
Non. SLES n'est pas une plateforme SQL Server 2025 prise en charge. Migrez une ancienne instance hébergée par SLES vers une cible RHEL ou Ubuntu prise en charge, normalement via un plan de sauvegarde et de restauration côte à côte.
Quelle est la dernière mise à jour Linux de SQL Server 2025 ?
Au 31 juillet 2026, il s'agit de CU7, build 17.0.4065.4, publiée le 16 juillet 2026. Vérifiez toujours les notes de version avant déploiement.
SQL Server 2025 peut-il s'exécuter dans un conteneur Linux ?
Oui, sur les hôtes Linux x86-64 pris en charge utilisant des processeurs Intel ou AMD. Conserver le stockage de la base de données, épingler la version de l'image, protéger les secrets et tester la sauvegarde et la récupération en dehors du conteneur.
Puis-je mettre les bases de données SQL Server sur tmpfs ?
Seul tempdb est pris en charge sur tmpfs. Il est volatile et sauvegardé en mémoire, alors dimensionnez-le et testez-le soigneusement. Les bases de données utilisateur et les bases de données système persistantes doivent rester sur un stockage durable pris en charge.
L'édition Standard utilise-t-elle plus de 32 cœurs ?
Une instance du moteur de base de données Standard est limitée au moindre de quatre sockets ou 32 cœurs. Les règles de licence et de virtualisation doivent encore être vérifiées pour le déploiement réel.
Les groupes de disponibilité remplacent-ils les sauvegardes ?
Non. La réplication peut améliorer la disponibilité, mais elle peut également reproduire une suppression ou une corruption. Conservez des sauvegardes chiffrées indépendantes et effectuez des tests de restauration planifiés.
Une licence SQL Server d'occasion est-elle légitime ?
Il peut s'agir d'une voie d'approvisionnement légitime où les conditions juridiques et de transfert de licence sont remplies. Conservez les documents de transaction et de provenance et validez l'édition, la métrique et la topologie pour le déploiement prévu.




