 FR
 EN
 DE
 IT
 PT
 ES


SigmaPlot : analyse statistique et graphiques scientifiques, guide 2026
Un graphique scientifique ne doit pas seulement faire bonne impression dans une présentation : il doit permettre de comprendre ce qui a été mesuré, la variabilité des résultats et la portée des conclusions. Lorsque ces détails comptent, un outil spécialisé aide à passer d’un tableau de chiffres à une figure que vous pouvez expliquer et examiner.
SigmaPlot réunit graphiques scientifiques, analyse statistique et ajustement de courbes dans un même environnement. Son intérêt réside dans l’articulation de ces tâches : explorer les données, choisir une analyse cohérente et représenter le résultat sans perdre de vue les observations initiales. Ce guide présente cette démarche à travers des exemples chiffrés hypothétiques et des choix pratiques pour le laboratoire, l’ingénierie, la recherche et l’enseignement.
L’année 2026 désigne ce guide ; la licence présentée est SigmaPlot 14. Il ne s’agit pas de deux noms pour une même version, et les nouveautés des éditions ultérieures ne sont pas attribuées à cette licence.
1. Ce que SigmaPlot apporte à un travail scientifique
L’intérêt d’un logiciel spécialisé apparaît lorsque vous devez maîtriser des détails qui influencent l’interprétation : un axe logarithmique, des barres d’erreur asymétriques, plusieurs séries sur les mêmes coordonnées ou une courbe ajustée aux côtés des mesures. Il se manifeste aussi lorsque vous souhaitez conserver un style lisible dans de nombreuses figures sans toutes les reconstruire.
SigmaPlot permet de travailler avec des feuilles de données, des graphiques et des rapports. Sa documentation décrit des assistants de création de graphiques et d’analyse, la personnalisation des axes et des légendes, la régression et l’ajustement de courbes. Ces fonctions sont utiles pour comparer des matériaux, étudier la réponse d’un échantillon à différentes concentrations ou montrer l’évolution d’un signal dans le temps.
Il n’est pas nécessaire d’opposer SigmaPlot au tableur. Vous pouvez commencer par organiser vos relevés dans un tableau, puis utiliser l’environnement scientifique pour explorer, modéliser et préparer la figure finale. L’essentiel est de conserver un lien clair entre les valeurs initiales, les transformations appliquées et le résultat publié.
Si cela correspond à votre travail, la licence SigmaPlot 14 chez Licendi est l’offre précise à examiner. Le choix est plus pertinent lorsqu’il répond à une analyse courante que lorsqu’il repose uniquement sur le nombre de types de graphiques annoncés.
2. SigmaPlot 14 et un guide d’utilisation en 2026
Il convient de distinguer trois éléments : la version du logiciel, la révision installée et la date d’un guide. Un article actualisé peut expliquer des méthodes valables pour une version antérieure sans en faire l’édition la plus récente. Grafiti propose une page consacrée à SigmaPlot 14.0 et une rubrique de mises à jour distinguant les révisions des différentes versions.
Pour suivre une procédure, consultez l’aide correspondant à votre installation. Une vidéo d’une autre édition peut éclairer un principe, mais ses boutons, ses menus ou ses fonctions supplémentaires ne correspondent pas nécessairement aux vôtres. Suivez donc la démarche et repérez les options équivalentes dans l’aide de votre version. Comprendre les données attendues par chaque analyse est plus utile que mémoriser l’emplacement d’un bouton.
L’offre consultée décrit une licence permanente pour un PC, en anglais, pour Windows 64 bits, avec livraison numérique. Cette description ne fait pas de l’achat un abonnement et ne garantit pas à elle seule des mises à niveau vers de futures versions. La version et l’environnement de travail doivent être vérifiés séparément.
3. Préparer les données avant de choisir un test
Commencez par formuler votre question en une phrase : « La résistance moyenne diffère-t-elle entre ces deux matériaux ? » est plus utile que « Je veux faire des statistiques ». Identifiez ensuite la variable réponse, ses unités, le facteur à comparer et ce qui constitue une unité expérimentale indépendante. Cette définition détermine l’analyse comme la taille de l’échantillon.
Une organisation pratique prévoit une ligne par observation et des colonnes pour l’identifiant, le groupe, la réponse, la date et toute condition pertinente. En présence de mesures répétées, conservez l’identifiant de l’échantillon. Si vous importez des données depuis Excel ou un fichier texte, vérifiez le séparateur décimal, les en-têtes et la bonne reconnaissance des colonnes numériques, parfois interprétées comme du texte.
Ne remplacez pas automatiquement les valeurs manquantes par zéro : zéro peut être un résultat valide et modifierait les moyennes, les dispersions et les pentes. Ne transformez pas non plus une valeur inférieure à la limite de détection en mesure exacte sans justifier son traitement. Conservez une copie des données initiales et consignez les corrections.
Lorsque vous repérez une valeur extrême, revenez au relevé d’origine. Il peut s’agir d’une erreur de transcription, d’un incident instrumental ou d’une observation authentique. Corriger une erreur avérée n’équivaut pas à supprimer une donnée gênante. Si une exclusion est justifiée, documentez-la et évaluez son influence sur la conclusion en réintégrant la valeur.
Une dernière vérification évite bien des erreurs : compter les unités réellement indépendantes. Mesurer trois fois la même éprouvette ne revient pas à disposer de trois éprouvettes. Les répétitions techniques renseignent sur la précision de la mesure, mais les traiter comme des échantillons indépendants peut donner une impression d’incertitude artificiellement faible.
4. Du fichier de données au premier graphique
Avant de lancer un test statistique, préparez une représentation simple. L’objectif initial consiste à repérer les valeurs inattendues, les groupes mal étiquetés ou les changements d’échelle ; une figure prête à publier n’est pas encore nécessaire. Dans SigmaPlot, la démarche générale passe par la feuille de données, la sélection des colonnes et l’assistant du type de graphique retenu.
- Vérifiez l’importation. Comparez plusieurs lignes au fichier original, notamment les décimales, les signes négatifs et les observations manquantes.
- Affectez correctement les variables. Pour étudier une relation entre concentration et réponse, placez la concentration en X et la réponse en Y.
- Affichez d’abord les observations. Un nuage de points révèle une structure qu’une ligne ou une barre pourrait masquer.
- Identifiez les unités et les groupes. « Temps (min) » renseigne mieux que « Variable 1 » ; une légende concise évite des explications ultérieures.
- Enregistrez une version exploratoire. Vous pourrez ainsi comparer l’aspect des données avant et après l’analyse.
Si des points se superposent, un léger décalage horizontal peut améliorer leur lisibilité dans des groupes catégoriels, à condition de ne pas modifier la réponse. En revanche, lorsque X est une variable quantitative, ne déplacez pas les coordonnées sans l’expliquer : vous pourriez modifier visuellement la relation étudiée.
Au moment de l’analyse, distinguez les colonnes d’observations initiales des colonnes de moyennes déjà calculées. Sélectionner six moyennes comme s’il s’agissait de six mesures individuelles change l’unité d’analyse. Conservez les résultats descriptifs à part et vérifiez dans le rapport le nombre d’observations utilisées ; ce décompte révèle les plages incomplètes et les cellules omises.
La première figure sert également à échanger avec un collègue : si la signification de chaque point n’est pas claire, mieux vaut la préciser avant d’interpréter le moindre résultat chiffré.
5. Un exemple complet avec deux groupes indépendants
Imaginez que vous compariez la résistance, en mégapascals, de deux formulations. Vous disposez de six éprouvettes indépendantes par formulation et obtenez les données suivantes, inventées pour vous exercer. Ce ne sont ni les résultats d’un essai réel ni une démonstration expérimentale d’un produit.
| Observation dans le groupe | Formulation A | Formulation B |
|---|---|---|
| 1 | 8 | 10 |
| 2 | 9 | 11 |
| 3 | 10 | 12 |
| 4 | 10 | 12 |
| 5 | 11 | 13 |
| 6 | 12 | 14 |
Les lignes ne représentent pas des paires : la première éprouvette de A n’est pas liée à la première de B. Les moyennes sont respectivement de 10 et 12 MPa. La différence B moins A est de 2 MPa, soit une augmentation de 20 % par rapport à la moyenne de A. Ce pourcentage décrit ces moyennes ; il ne signifie pas que toutes les éprouvettes progressent de 20 %.
Pour A, les écarts à la moyenne sont −2, −1, 0, 0, 1 et 2. La somme de leurs carrés vaut 10. Pour obtenir la variance d’échantillon, on divise cette somme par cinq, et non par six : elle vaut 2 MPa². L’écart-type est la racine de 2, soit environ 1,41 MPa. B présente exactement la même dispersion.
Lorsque vous saisissez cet exemple, vérifiez d’abord que vous retrouvez ces valeurs. Cela permet de contrôler simplement les colonnes sélectionnées et l’utilisation de l’écart-type d’échantillon. Représentez ensuite les douze points et ajoutez le résumé adapté à votre question, sans dissimuler les données derrière deux barres opaques.
6. Écart-type, SEM et intervalle de confiance
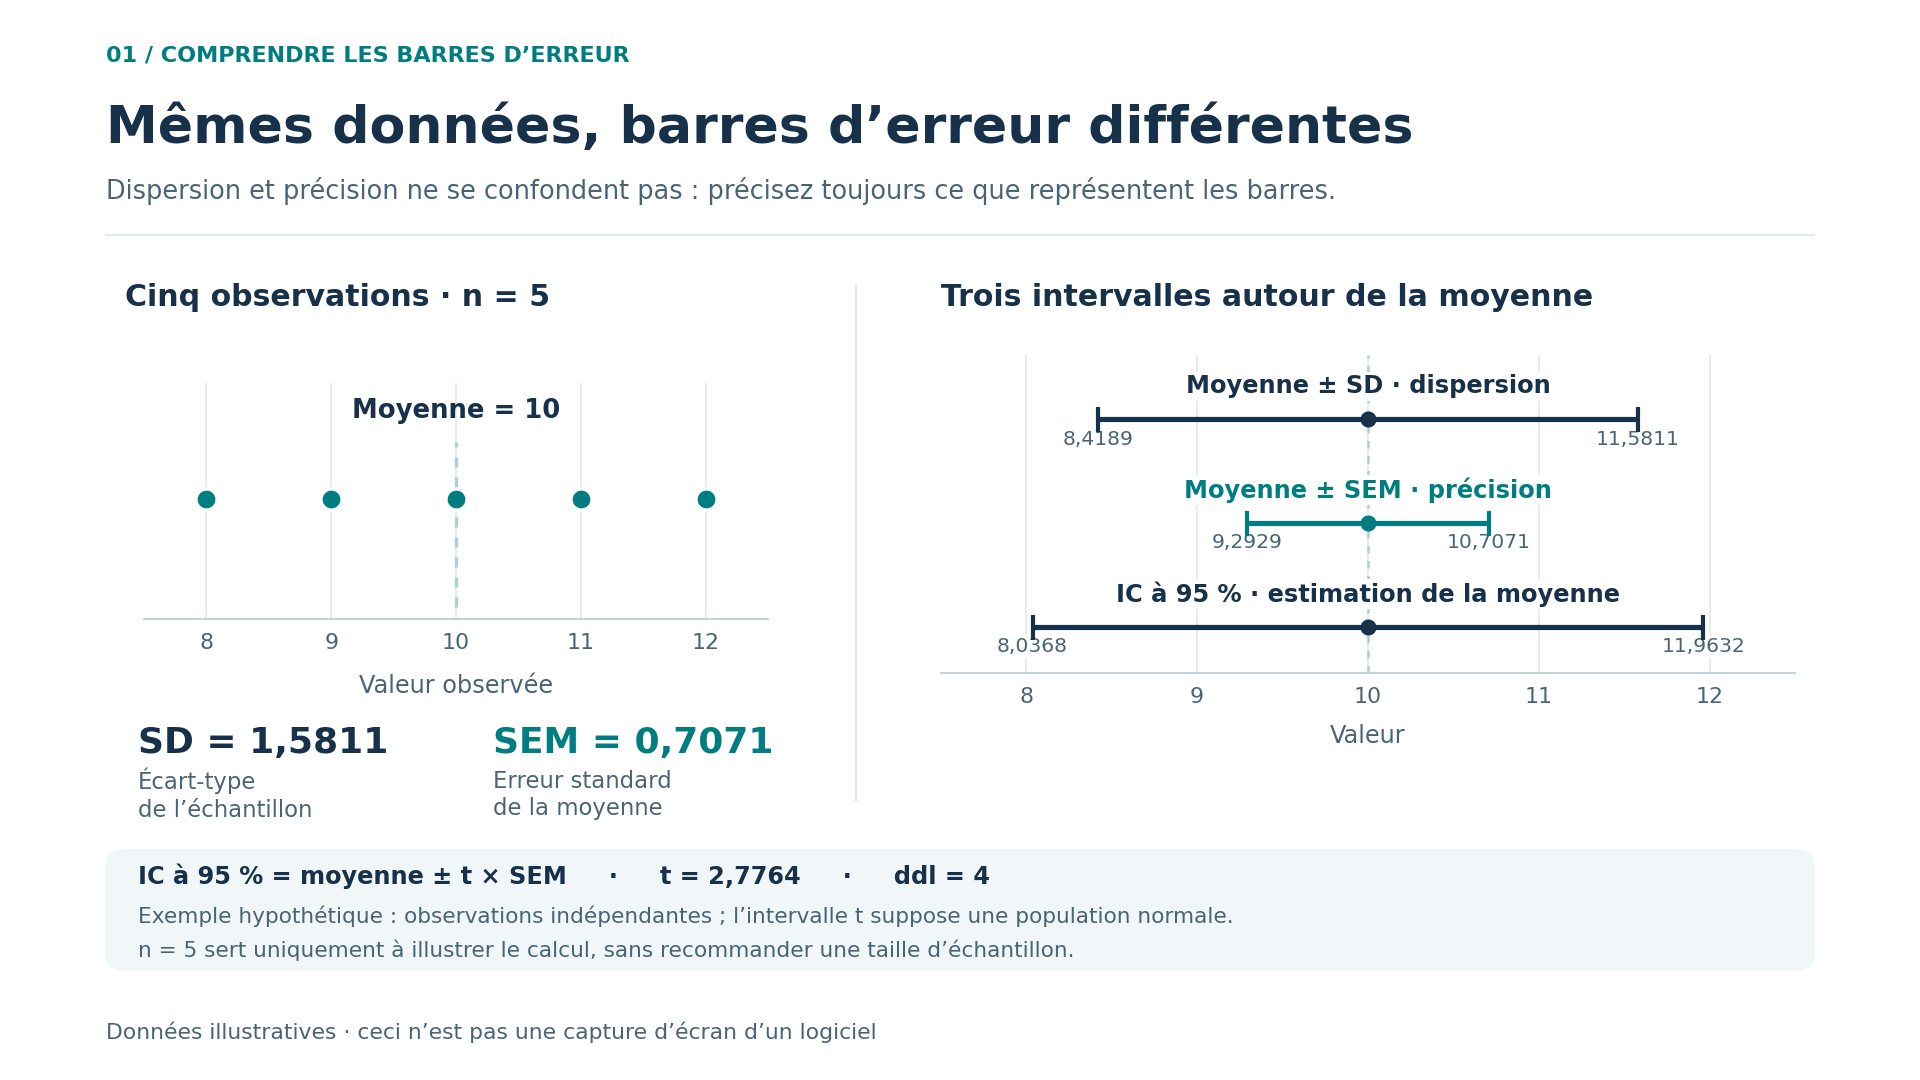
Ces trois mesures ne sont pas interchangeables. L’écart-type, abrégé ET ou SD, décrit la dispersion des observations autour de leur moyenne. Dans cet exemple, il vaut 1,41 MPa par groupe. Il convient lorsque vous souhaitez montrer la variabilité entre éprouvettes.
L’erreur standard de la moyenne, ou SEM, quantifie l’incertitude de la moyenne estimée sous les hypothèses de l’échantillonnage. Elle se calcule en divisant SD par la racine carrée de n. Ici, 1,414 divisé par la racine de six donne environ 0,577 MPa. Une SEM inférieure à SD ne signifie pas que les éprouvettes sont plus homogènes.
Un intervalle de confiance à 95 % ajoute une marge autour de l’estimation. Pour une moyenne dont l’écart-type de population est inconnu, sous le modèle habituel d’observations normales indépendantes, on utilise la loi t. Avec six observations, le coefficient multiplicateur vaut environ 2,571 : la marge est de 1,484 MPa. Les intervalles sont 8,52–11,48 MPa pour A et 10,52–13,48 MPa pour B.
Calculez avec la précision disponible et arrondissez à la présentation. Si vous remplacez prématurément 0,577 par 0,6, de petits écarts s’accumulent dans les bornes. Deux décimales peuvent suffire dans une figure ; dans le fichier de calcul, conservez les valeurs non arrondies.
L’interprétation des 95 % porte sur la procédure : en répétant de nombreuses fois l’échantillonnage sous les mêmes hypothèses, environ 95 % des intervalles ainsi construits contiendraient la moyenne de population. Cela ne signifie pas que 95 % des éprouvettes se situent dans l’intervalle.
7. Comparer les moyennes sans se fier à l’aspect du graphique
Pour deux groupes indépendants et une réponse quantitative, la comparaison des moyennes peut s’effectuer par un test t. La variante de Welch ne suppose pas l’égalité des variances de population. Le choix doit correspondre au plan expérimental et aux hypothèses, et non à la procédure donnant la plus petite valeur p.
Dans l’exemple des formulations A et B, l’erreur standard de la différence est la racine carrée de 2/6 + 2/6, soit environ 0,816 MPa. Diviser la différence de 2 MPa par cette valeur donne une statistique t de 2,449. La comparaison bilatérale de Welch possède ici dix degrés de liberté et donne p ≈ 0,0343. L’intervalle de confiance à 95 % de B moins A est d’environ 0,18–3,82 MPa.
Les intervalles individuels de A et B se chevauchent, mais celui de la différence ne contient pas zéro. Aucune contradiction : ces intervalles concernent des paramètres différents. Il ne faut donc pas décider de la significativité d’une différence en regardant uniquement si les barres de deux moyennes se touchent.
Avec de petits échantillons, examinez attentivement les observations extrêmes et la plausibilité du modèle. Un test de normalité ne détectant aucun problème ne prouve pas que la distribution est normale. Dans SigmaPlot, lisez les vérifications et le rapport complet, mais gardez à l’esprit la manière dont les données ont été obtenues : aucun assistant ne peut reconstruire un plan expérimental non documenté.
8. Lorsque les données sont appariées
Si vous mesurez les mêmes échantillons avant et après un traitement, la question change. Vous cherchez désormais à connaître la variation de chaque échantillon, et non à comparer deux ensembles comme s’ils étaient indépendants. Les observations sont appariées parce qu’une correspondance réelle est établie par le plan expérimental.
Organisez les colonnes avec un identifiant et les deux mesures. Calculez la variation de chaque unité en conservant le même sens, par exemple après moins avant. Un test t apparié analyse la moyenne de ces variations ; son hypothèse de normalité concerne les différences, et les paires doivent être indépendantes entre elles.
Un graphique de points reliés révèle ce que les moyennes peuvent masquer : certains échantillons s’améliorent beaucoup, d’autres peu, et certains peuvent se dégrader. Si l’une des deux mesures manque, n’appariez pas l’observation restante avec un autre échantillon pour compléter la ligne. Documentez l’absence et la règle d’analyse.
Un même nombre de données dans deux colonnes ne suffit pas à les rendre appariées. Mesurer les deux groupes le même jour ne suffit pas non plus. Inversement, ignorer un véritable appariement peut faire perdre de l’information. Avec davantage de temps de mesure, des regroupements par centre ou plusieurs observations par sujet, la stratégie d’analyse doit représenter cette dépendance.
9. Plus de deux groupes : ANOVA et comparaisons planifiées
Avec trois formulations, effectuer un test t pour chaque paire semble prolonger naturellement l’exemple, mais multiplie les occasions d’obtenir des résultats apparemment significatifs par hasard. Une ANOVA à un facteur pose d’abord une question globale : les moyennes de population des groupes sont-elles égales ?
Un résultat global significatif n’identifie pas, à lui seul, les groupes qui diffèrent. Pour répondre à cette seconde question, il faut définir des contrastes ou des comparaisons multiples appropriés. Comparer chaque formulation à un témoin n’a pas le même objectif que comparer toutes les paires. Mieux vaut le décider avant d’examiner les résultats.
L’ANOVA classique repose sur des hypothèses d’indépendance, de distribution des erreurs et d’homogénéité de leurs variances. L’examen des résidus aide à évaluer l’adéquation du modèle. Lorsque les hypothèses ne conviennent pas, envisagez des méthodes adaptées à des variances différentes, des transformations justifiées ou des solutions fondées sur les rangs, selon votre question et les outils disponibles.
Les méthodes non paramétriques ne constituent pas non plus une solution automatique pour tout jeu de données. Elles conservent des exigences de conception et ne testent pas toujours la même propriété qu’une comparaison de moyennes. Dans le rapport, précisez le paramètre ou l’aspect de la distribution comparé ; changer de test sans revoir l’interprétation peut conduire à répondre à une autre question.
10. Ce que signifie une valeur p et ce qu’il reste à préciser
Une valeur p résume le degré d’incompatibilité des données avec une hypothèse nulle et le modèle utilisé : elle exprime la probabilité, dans ces conditions, d’obtenir une statistique aussi extrême ou plus extrême que celle observée. Ce n’est ni la probabilité que l’hypothèse nulle soit vraie, ni une mesure directe de l’importance de l’effet.
Dans l’exemple, p ≈ 0,0343 accompagne une différence estimée à 2 MPa. Si une amélioration inférieure à 1 MPa n’a pas d’utilité technique, l’intervalle 0,18–3,82 MPa laisse cette question ouverte : il contient des valeurs inférieures et supérieures au seuil pratique. Le modèle fournit des éléments en faveur d’une différence, mais son ampleur demeure imprécise.
Pour la même raison, une valeur p supérieure à 0,05 ne démontre pas l’équivalence. Elle peut refléter une faible différence, un échantillon insuffisant ou des données très variables. Démontrer l’équivalence exige une marge pertinente et une procédure spécifique ; l’absence de significativité d’une comparaison classique ne suffit pas.
Une formulation informative serait : « Dans cet exemple hypothétique, B dépasse A de 2 MPa ; IC à 95 % de la différence : 0,18–3,82 MPa ; test t bilatéral de Welch, p = 0,0343 ; six éprouvettes indépendantes par groupe ». Le lecteur dispose ainsi de la taille de l’effet, de son incertitude et du plan expérimental, plutôt que d’un simple astérisque.
11. Régression : examiner la courbe, mais aussi les résidus
Lorsque vous cherchez comment une réponse évolue avec une variable quantitative, la régression est plus informative qu’un découpage artificiel de cette variable en groupes. Commencez par un nuage de points et un modèle compatible avec le phénomène. Pour une droite, la pente exprime la variation attendue de Y pour chaque unité supplémentaire de X.
Prenez un autre exemple conçu pour vous exercer : X prend les valeurs 0, 1, 2, 3, 4 et 5 ; Y vaut 1,2 ; 2,8 ; 4,8 ; 7,2 ; 9 et 11. L’ajustement par moindres carrés ordinaires donne Y estimée = 1 + 2X. Les résidus, observation moins prédiction, sont 0,2 ; −0,2 ; −0,2 ; 0,2 ; 0 et 0. Le R² vaut environ 0,9977.
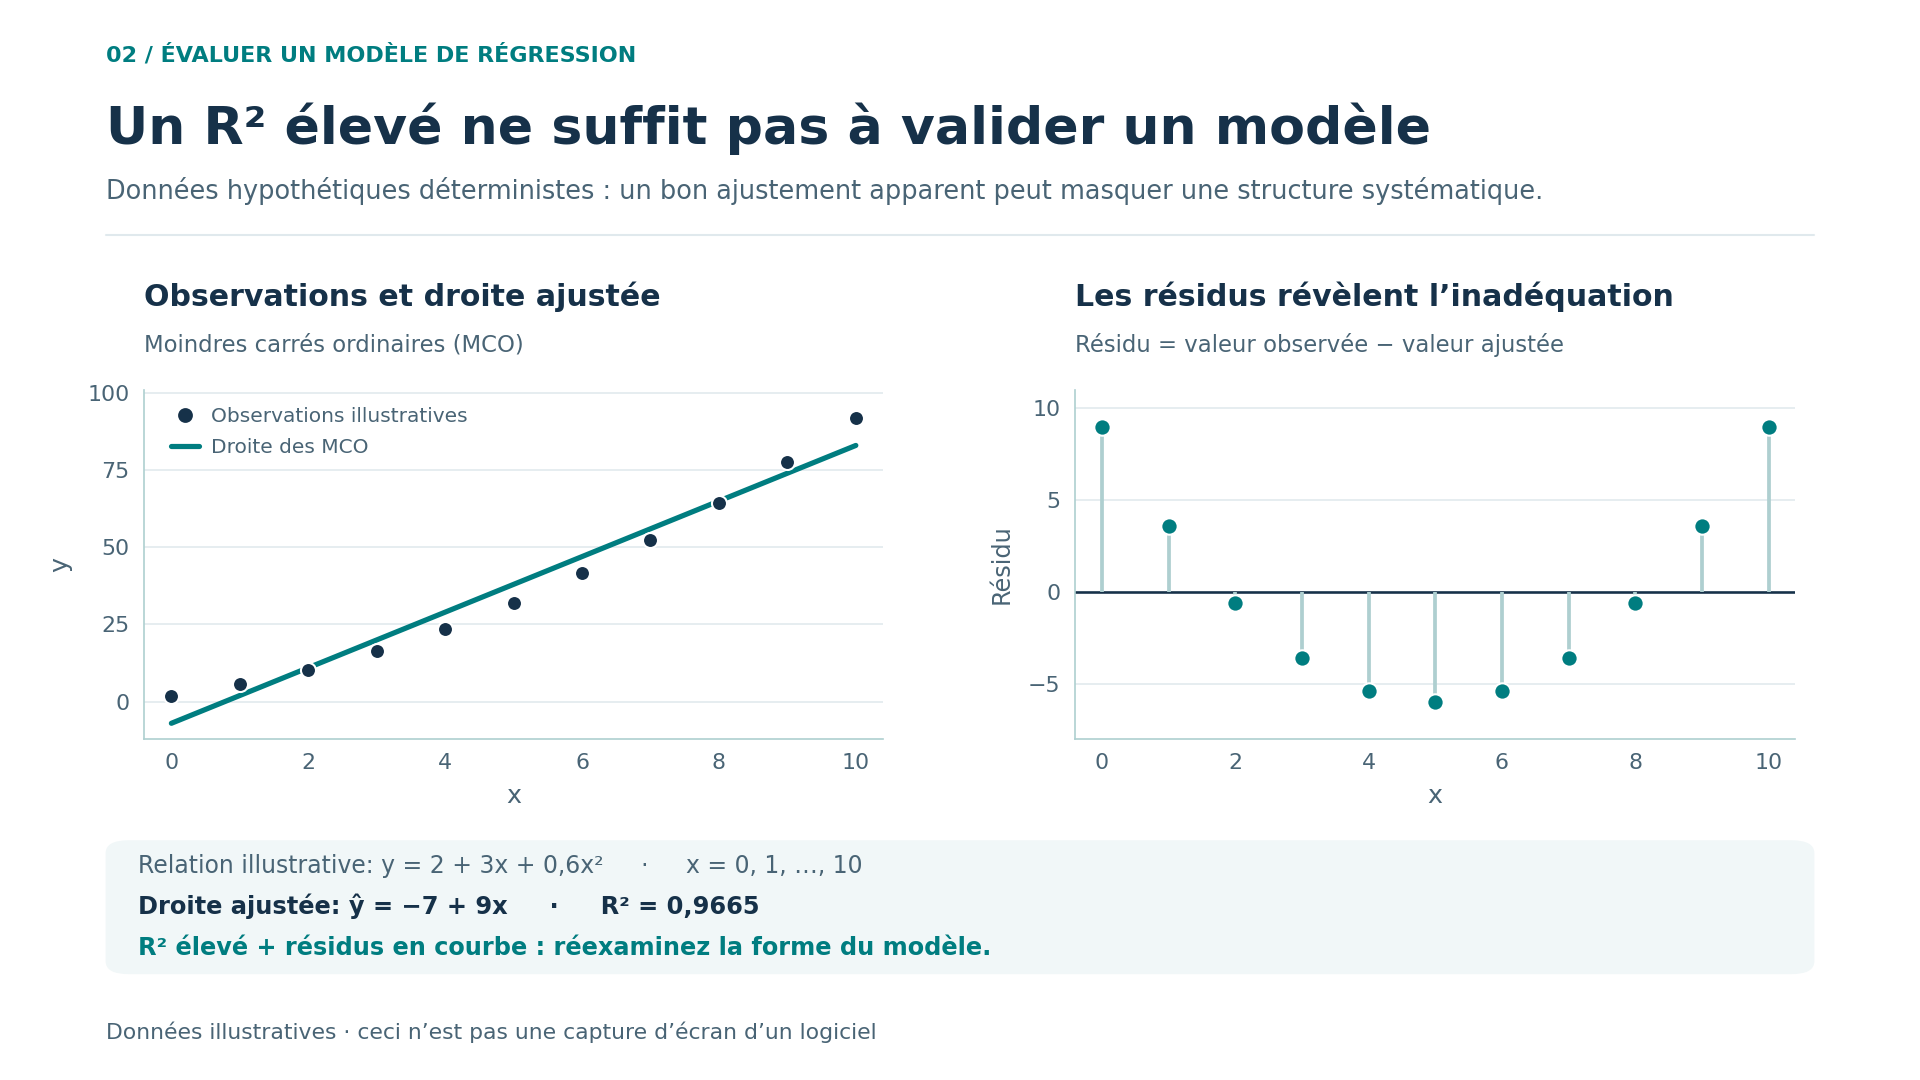
Cette valeur résume l’ajustement, mais ne remplace pas le diagnostic. Une courbure des résidus suggère une forme fonctionnelle inadaptée ; un éventail peut indiquer une variabilité non constante ; une séquence temporelle peut révéler une dépendance ou une dérive. Six points apportent une information limitée : un tracé apparemment net ne valide pas toutes les hypothèses.
Une association n’établit pas non plus de causalité. Si température et réponse augmentent ensemble, cela peut traduire un mécanisme direct, une troisième variable ou une tendance temporelle commune. L’interprétation dépend du plan expérimental, des contrôles et de la connaissance du processus, pas seulement de la pente. La régression décrit des relations ; une expérience bien conçue permet d’en étudier les causes.
Pour illustrer le problème, prenez maintenant X = 0, 1, …, 10 et calculez Y = 2 + 3X + 0,6X². Une droite obtient R² ≈ 0,9665, alors que les résidus dessinent un U évident : les données ont été construites selon une relation quadratique. Cet exemple montre pourquoi « R² élevé » ne signifie pas « modèle adapté ».
12. Ajustement non linéaire : ne pas chercher seulement une jolie courbe
Une réponse tendant vers un plateau, une dégradation exponentielle ou une relation dose-réponse peuvent nécessiter des modèles non linéaires. SigmaPlot propose des outils d’ajustement de courbes ; la documentation de Grafiti présente l’assistant de régression et la recherche de valeurs initiales par ajustement dynamique.
L’étape décisive reste le choix d’une équation pertinente. Ajouter des paramètres facilite souvent le rapprochement de la courbe et des points, mais peut produire des estimations instables et de mauvaises prédictions. Sans mesures proches d’un plateau, par exemple, la valeur asymptotique peut rester très mal déterminée malgré une courbe convaincante.
Consignez l’équation, les unités des paramètres, les valeurs initiales, les contraintes et toute pondération. Essayez plusieurs points de départ raisonnables lorsque le problème le nécessite. La convergence numérique signifie que l’algorithme a atteint une solution selon ses critères ; elle ne prouve ni son unicité ni la bonne représentation du processus par le modèle.
La pondération mérite un choix explicite. Lorsque certaines observations présentent une variance supérieure à d’autres, leur attribuer le même poids peut être inadapté. Les poids doivent refléter un modèle d’incertitude défendable, et non rapprocher la courbe des points préférés. Expliquez leur origine et examinez les résidus de manière cohérente.
Distinguez également interpolation et extrapolation. Estimer dans l’intervalle mesuré n’offre pas les mêmes garanties que prolonger une courbe vers des concentrations ou des temps non observés. Si vous présentez une prédiction, précisez son domaine de validité. Ne confondez pas l’intervalle de confiance de la réponse moyenne avec l’intervalle de prédiction d’une nouvelle observation : ce dernier intègre une variabilité supplémentaire.
13. Choisir le graphique qui répond à la question
Pour comparer de petits groupes, les points individuels sont souvent plus informatifs qu’une barre représentant la moyenne. Avec davantage d’observations, une boîte à moustaches peut résumer la distribution, à condition de préciser la signification de la boîte et des moustaches. Un histogramme aide à explorer la forme et l’asymétrie, même si son aspect dépend des classes choisies.
Pour deux variables quantitatives, utilisez un nuage de points. Pour une évolution temporelle, une ligne aide à suivre l’ordre, mais ne doit pas suggérer des mesures jamais effectuées. Dans un plan apparié, relier les observations d’une même unité rend sa trajectoire visible. Dans tous les cas, la représentation doit respecter le recueil des données.
Les graphiques tridimensionnels se justifient lorsqu’une troisième dimension apporte une véritable information. S’ils servent seulement à donner du volume aux barres, ils ajoutent de la perspective et compliquent la comparaison des hauteurs. Pour plusieurs conditions expérimentales, de petits panneaux aux échelles cohérentes peuvent être préférables à une figure unique surchargée.
Avant de choisir un outil, pensez à deux ou trois figures que vous produisez régulièrement. Examiner les possibilités de SigmaPlot 14 pour les graphiques scientifiques et l’analyse de données avec ces exemples en tête permet d’évaluer son utilité concrète : nul besoin d’utiliser toutes les options pour profiter d’un environnement spécialisé.
14. Axes, barres d’erreur et légendes sans ambiguïté
Les axes participent à l’argumentation. Dans un graphique à barres, commencer l’axe vertical loin de zéro peut exagérer les différences, car nous comparons des longueurs. Dans un nuage de points, une plage resserrée peut se justifier pour étudier de faibles variations, à condition que l’échelle soit claire et qu’aucune information pertinente ne soit masquée.
Une échelle logarithmique est utile lorsque les valeurs positives couvrent plusieurs ordres de grandeur ou que les variations multiplicatives vous intéressent. Elle doit être clairement identifiée et n’accepte ni zéro ni valeurs négatives dans sa forme habituelle. Modifier l’échelle visuelle n’équivaut pas nécessairement à transformer la variable pour l’analyse : consignez séparément ces deux décisions.
Précisez toujours ce que représentent les barres d’erreur : SD, SEM, intervalle de confiance ou autre mesure. Si vous saisissez des bornes inférieure et supérieure, vérifiez si la boîte de dialogue attend des limites absolues ou des distances par rapport à la valeur centrale. Confondre ces formats déplace les barres, même lorsque les nombres d’origine sont corrects.
Utilisez des couleurs distinctes, combinées à des symboles ou des styles de ligne. Vérifiez que la figure reste compréhensible en niveaux de gris. Une légende utile précise les groupes, la taille de l’échantillon et le résumé représenté ; elle n’a pas à répéter toute la méthodologie. Supprimez les décimales superflues, les fonds décoratifs et les quadrillages qui concurrencent les observations.
15. Exporter et conserver une analyse reproductible
Pensez à la destination avant d’exporter : une diapositive, un mémoire et une revue peuvent imposer des dimensions différentes. Lorsque le support et l’installation le permettent, un format vectoriel conserve la netteté des lignes et des libellés au redimensionnement. Si une image matricielle est nécessaire, prévoyez des dimensions suffisantes pour sa taille finale, et pas seulement une valeur de résolution.
Rouvrez le fichier exporté hors du logiciel. Vérifiez les caractères spéciaux, les unités, les exposants, l’épaisseur des lignes et les éventuels éléments tronqués. Un libellé confortable à l’écran peut devenir illisible lorsque la figure est réduite à une colonne. Vérifiez aussi que la version envoyée correspond à la dernière révision des données.
Pour reproduire le travail, conservez les données initiales, le tableau préparé, le fichier modifiable, les rapports et la figure finale. Ajoutez une courte fiche indiquant la version et la révision du logiciel, les exclusions justifiées, les transformations, le test utilisé et les options pertinentes. Pour les ajustements, conservez également l’équation et les choix de paramètres et de pondération.
Un dossier bien organisé n’est pas une formalité bureaucratique : il permet de répondre à une demande de révision sans reconstituer l’expérience de mémoire. Une autre personne doit pouvoir identifier l’origine de chaque panneau et les changements entre deux livraisons. La reproductibilité consiste à conserver les décisions, pas seulement à recréer une image ressemblante.
16. Choisir sa licence avec discernement
L’achat devient plus simple lorsque vous savez ce que vous devez produire. Dressez une courte liste : graphiques habituels, tests statistiques nécessaires, échanges de fichiers et ordinateur de travail. Si vous collaborez avec un laboratoire, vérifiez aussi sa version du logiciel et le format dont il a besoin pour examiner les résultats.
L’offre Licendi retenue pour ce guide est SigmaPlot 14 : licence permanente pour un PC, en anglais, pour Windows 64 bits, avec livraison numérique. La langue compte pour suivre les menus et la documentation ; le nombre d’ordinateurs compte pour organiser votre poste de travail. La compatibilité d’un système précis doit être vérifiée dans les exigences de cette version.
« Permanente » décrit la durée de la licence proposée, sans promettre de nouvelles versions, une compatibilité avec tout futur système ou des services illimités. Si vous avez des besoins particuliers d’installation, de transfert ou d’utilisation sur plusieurs postes, clarifiez-les avant l’achat plutôt que de les déduire du nom du produit. Vous choisirez ainsi selon vos besoins réels, sans confondre différentes formules.
Vous pouvez consulter la fiche de SigmaPlot 14 et ses conditions chez Licendi pour évaluer cette configuration. L’objectif n’est pas d’accumuler des fonctions, mais de disposer d’un cheminement clair entre données, analyse et figure. Lorsque chaque point, barre et conclusion s’explique, le logiciel devient une aide pratique pour mieux communiquer votre travail.
17. Sources et documentation pour approfondir
Documentation officielle consultée pour les fonctions générales, la distinction entre versions et les fondements statistiques :
- Grafiti : page consacrée à SigmaPlot 14.0 et mises à jour par version.
- Grafiti : fonctions graphiques et d’analyse et ajustement de courbes et régression.
- NIST : intervalles de confiance de la moyenne et comparaison de deux moyennes.
- NIST : ANOVA à un facteur, validation par les résidus et régression non linéaire.




