 ES
 EN
 FR
 DE
 IT
 PT


SQL Server 2025 en Linux: guía práctica de despliegue
Ejecutar SQL Server en Linux ha dejado de ser una alternativa experimental. Para las organizaciones que ya están estandarizadas en Red Hat Enterprise Linux o Ubuntu, SQL Server 2025 hace posible mantener herramientas de base de datos familiares mientras integra el motor en un modelo operativo Linux establecido. El atractivo no es simplemente evitar Windows. Es la capacidad de utilizar la misma automatización, observabilidad, plataformas de contenedores, controles de seguridad y habilidades de infraestructura que ya respaldan el resto del conjunto de aplicaciones.
Esa flexibilidad no elimina las decisiones arquitectónicas. Una implementación de producción confiable aún depende de elegir una distribución compatible, aplicar la actualización acumulativa correcta, dimensionar deliberadamente el almacenamiento y la memoria, proteger secretos, probar la recuperación y hacer coincidir la topología con la edición y licencia correctas. Esta guía sigue ese camino desde la primera reunión de diseño hasta la lista de verificación operativa.
Empiece con una versión de referencia precisa
SQL Server 2025, la generación 17.x, estuvo disponible de forma generalizada el 18 de noviembre de 2025. A partir del 31 de julio de 2026, la última actualización acumulativa es CU7, lanzada el 16 de julio de 2026, con el número de compilación 17.0.4065.4. Esas fechas son importantes porque “SQL Server 2025” no es una línea base de producción suficientemente precisa. Los registros de instalación, la gestión de la configuración y los informes de incidentes deben nombrar la edición, la compilación, la distribución de Linux, el kernel y el resumen de la imagen del contenedor cuando corresponda.
Las actualizaciones acumulativas de Microsoft son acumulativas: una nueva instalación normalmente puede pasar directamente a la CU actual en lugar de aplicar todos los paquetes anteriores. Sin embargo, una actualización debe pasar primero por un entorno representativo que no sea de producción. Pruebe la conectividad de las aplicaciones, los trabajos del Agente SQL, la copia de seguridad y la restauración, el comportamiento de los grupos de disponibilidad, las extensiones, los controladores y la supervisión. Mantenga una ruta de reversión o recuperación acordada. Las notas oficiales de la versión de Linux de SQL Server 2025 son el lugar adecuado para confirmar las compilaciones actuales y los problemas conocidos antes de una ventana de mantenimiento.
Elija el modelo operativo antes de elegir los comandos
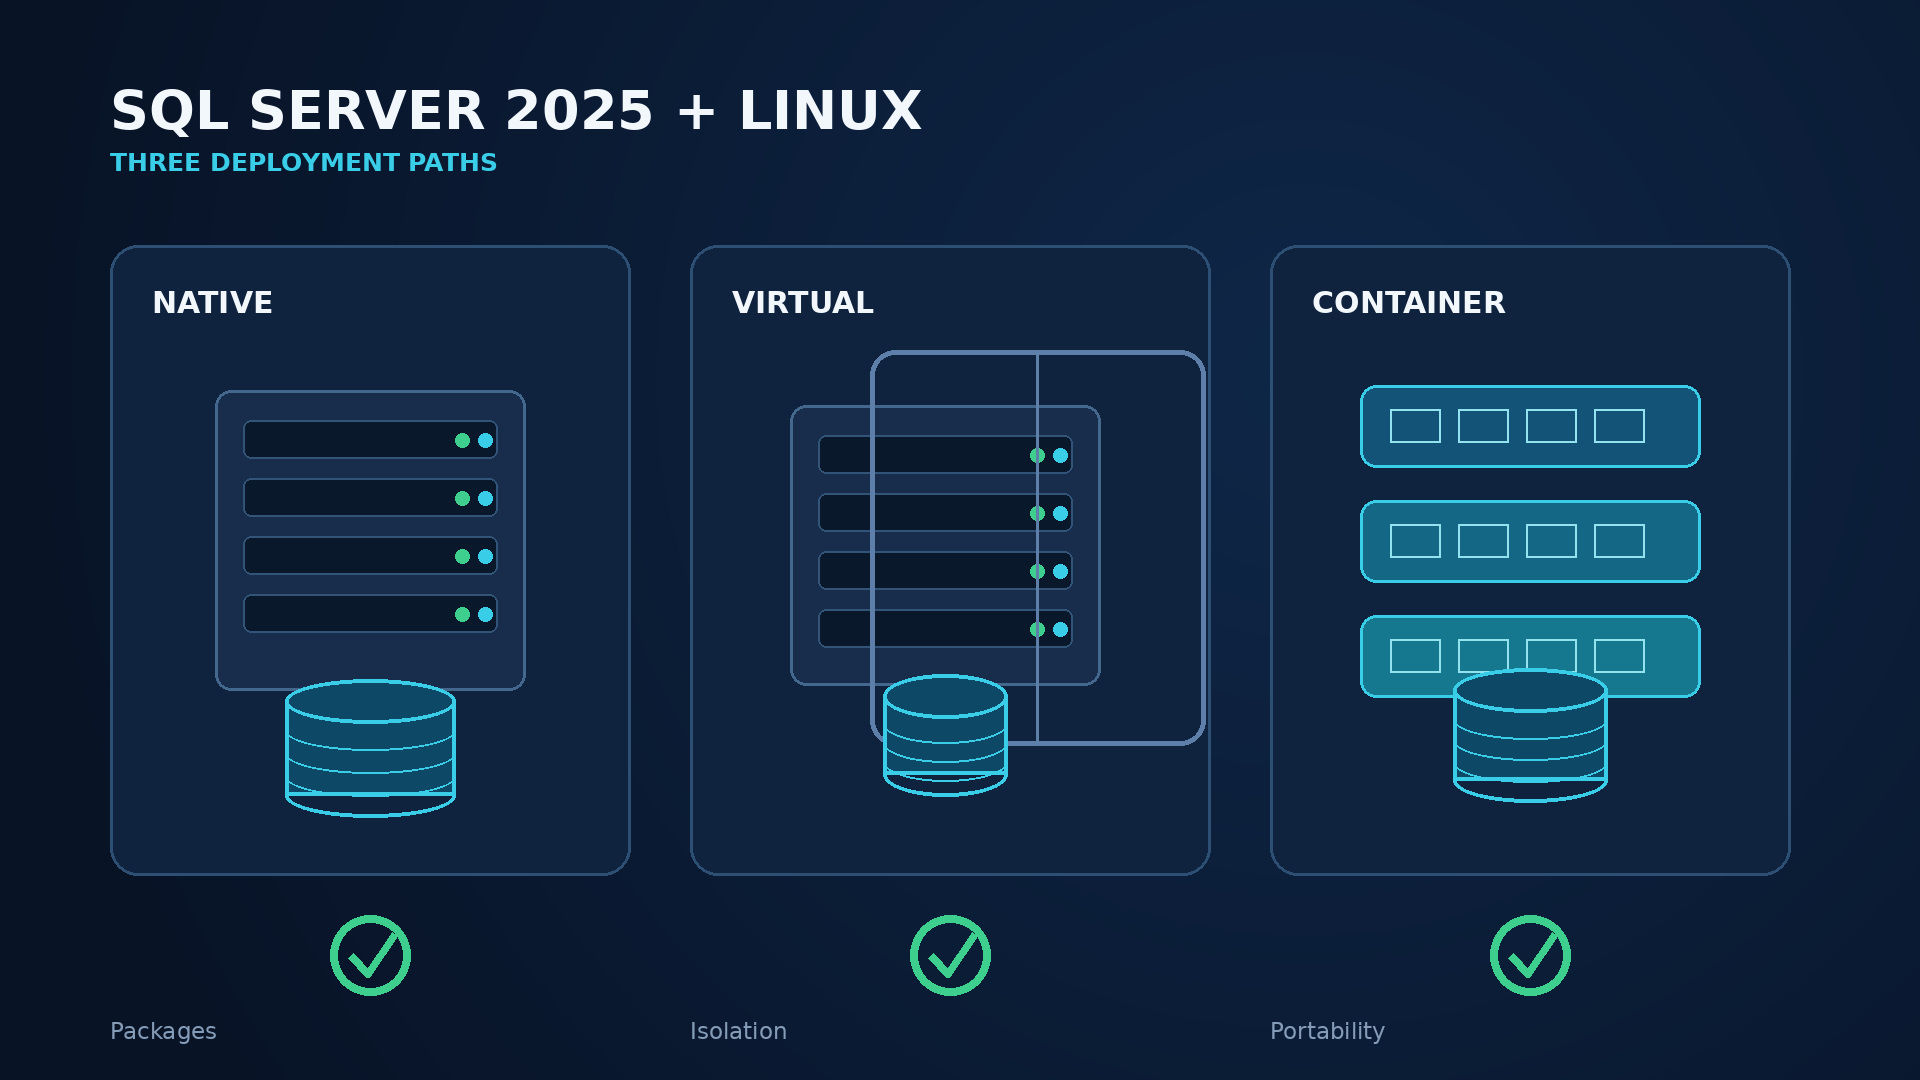
Hay cuatro patrones comunes. La instalación de un paquete nativo coloca SQL Server directamente en una máquina virtual o servidor Linux compatible. Ofrece una integración sencilla con systemd y, a menudo, es la opción más clara para hosts de bases de datos estables y de larga duración. Una máquina virtual agrega aislamiento de infraestructura, instantáneas para los flujos de trabajo de la infraestructura y opciones familiares de recuperación ante desastres, pero la base de datos aún necesita respaldo y recuperación compatibles con SQL. Un contenedor empaqueta el motor y las dependencias en un artefacto repetible mientras deja la persistencia, los secretos y la orquestación a la plataforma. Una base de datos en la nube administrada transfiere más responsabilidad operativa a un proveedor, aunque no es el mismo producto o superficie de control que una instancia de Linux autoadministrada.
| Modelo | Mejor ajuste | Carga de diseño principal |
|---|---|---|
| Host nativo o VM | Servicio de base de datos predecible y de larga duración | Ciclo de vida del SO, parches y HA del host |
| Contenedor | Implementación repetible con plataforma madura ingeniería | Almacenamiento persistente, secretos, programación y recuperación |
| Servicio administrado | Equipos que prefieren infraestructura operada por el proveedor | Restricciones de servicio, ajuste de migración y modelo recurrente |
Plataformas Linux compatibles: una lista breve por una razón
Para un servidor SQL nativo Instalación de 2025, Microsoft admite RHEL 9 y 10 y Ubuntu 22.04 y 24.04, usando XFS o ext4. RHEL 10 y Ubuntu 24.04 eran opciones de vista previa en disponibilidad general y pasaron a ser totalmente compatibles a partir de CU1 el 29 de enero de 2026. SUSE Linux Enterprise Server no es compatible con SQL Server 2025. Si una instancia anterior de SQL Server se ejecuta actualmente en SLES, actualizar los archivos binarios existentes no es el camino hacia 2025; planifique un movimiento en paralelo, normalmente realizando una copia de seguridad y restaurando las bases de datos en un destino compatible.
La matriz de soporte es un límite de ingeniería, no una sugerencia. Una distribución que técnicamente puede instalar un RPM o ejecutar un proceso no es automáticamente una plataforma de producción compatible. Fije la versión de distribución principal elegida en el registro de arquitectura y confírmela con la guía de configuración actual de Linux de Microsoft. Verifique también la posición de soporte de la capa de virtualización, el controlador de almacenamiento, la pila de clustering y el agente de respaldo. La base de datos puede ser compatible, mientras que un componente circundante esencial no lo es.
Planifique la capacidad y la topología antes de instalar
Comience con evidencia de carga de trabajo: transacciones máximas por segundo, sesiones simultáneas, crecimiento de la base de datos, combinación de lectura/escritura, tamaño del conjunto de trabajo, consultas más grandes, ventanas por lotes y objetivos de recuperación. Los requisitos mínimos de instalación no describen un servidor de producción en buen estado. SQL Server compite por CPU, memoria y E/S con el kernel, los agentes de seguridad, el software de respaldo y el monitoreo. Deje un margen de maniobra explícito en lugar de asignar todos los recursos a la base de datos.
Para SQL Server Standard, observe el límite de capacidad de procesamiento: una instancia de Database Engine puede usar el menor de cuatro sockets o 32 núcleos. La guía de licencias también expresa el límite estándar en 32 núcleos con licencia. Agregar vCPU más allá del límite admitido no convierte a Standard en Enterprise y puede complicar los costos y el cumplimiento. Si la carga de trabajo realmente requiere más computación, operaciones en línea avanzadas o capacidades de alta disponibilidad más amplias, compare Enterprise antes de finalizar la plataforma.
Instalación nativa en RHEL o Ubuntu
Una compilación de producción debe automatizarse, pero los administradores deben comprender qué hace la automatización. El flujo de trabajo típico es aprovisionar un sistema operativo compatible, parchearlo, configurar DNS y sincronización horaria, montar volúmenes de datos, agregar el repositorio de paquetes firmados de Microsoft, instalar el paquete mssql-server, ejecutar la configuración inicial, seleccionar la edición, aceptar los términos, configurar la credencial de administrador del sistema de forma segura e iniciar el servicio systemd. Las herramientas cliente como sqlcmd se pueden instalar por separado en los hosts administrativos.
No coloque una contraseña de administrador real en el historial del shell, en los registros de inicio de la nube o en un repositorio de configuración. Utilice el administrador secreto de la organización y un proceso de arranque controlado. Después de la configuración, verifique systemctl status mssql-server, revise el registro de errores de SQL Server, conéctese localmente con cifrado y consulte SERVERPROPERTY('ProductVersion'), SERVERPROPERTY('Edition') y las rutas de datos configuradas. Aplique la CU aprobada antes de incorporar los datos de producción.
Mueva los directorios de registros y datos predeterminados solo a través de la configuración documentada de SQL Server, no improvisando enlaces simbólicos. Establezca la propiedad y los permisos de forma estricta para la cuenta mssql. Abra TCP 1433 sólo cuando sea necesario; un puerto predeterminado expuesto a toda una red no es un logro de implementación. Defina explícitamente las fuentes del firewall, las rutas de administración y las cadenas de conexión de aplicaciones. Finalmente, registre cada configuración de mssql-conf no predeterminada en la documentación de infraestructura controlada por versión.
Contenedores: repetible no significa que los datos sean desechables
Microsoft admite imágenes de contenedor de SQL Server 2025 en hosts Linux x86-64 con procesadores Intel o AMD. Los entornos de traducción y emulación como Rosetta 2, Prism y QEMU no están probados ni son compatibles. Fije una imagen de producción a una etiqueta CU aprobada y preferiblemente a un resumen inmutable; el uso de una etiqueta flotante hace que sea difícil demostrar qué cambió entre reinicios.
El contenedor debe ejecutarse como un usuario no root, recibir su secreto a través del orquestador o almacén de secretos y usar almacenamiento persistente para /var/opt/mssql o un diseño de datos deliberadamente separado. Valide la clase de almacenamiento en cuanto a latencia, rendimiento, comportamiento de fsync, archivos adjuntos de conmutación por error e instantáneas. Un volumen que funcione para una caché web puede no ser adecuado para un registro de transacciones con mucha escritura. Establezca solicitudes y límites de CPU y memoria con margen medido. SQL Server 2025 comprende cgroup v2, lo que mejora el conocimiento de los recursos asignados por Linux y las plataformas de contenedores modernas, pero los límites deficientes aún producen un rendimiento deficiente.
Las comprobaciones de estado deben distinguir "el proceso existe" de "la base de datos acepta trabajo útil". Agregue una asignación de inicio para la recuperación de fallos, evite los bucles de reinicio que interrumpen la recuperación y drene el tráfico de las aplicaciones antes del reemplazo planificado del pod. Las copias de seguridad deben salir del dominio de error del contenedor. Pruebe restaurarlos en una instancia limpia creada a partir de la misma imagen y configuración documentadas.
Rendimiento: diseñe primero la ruta de E/S
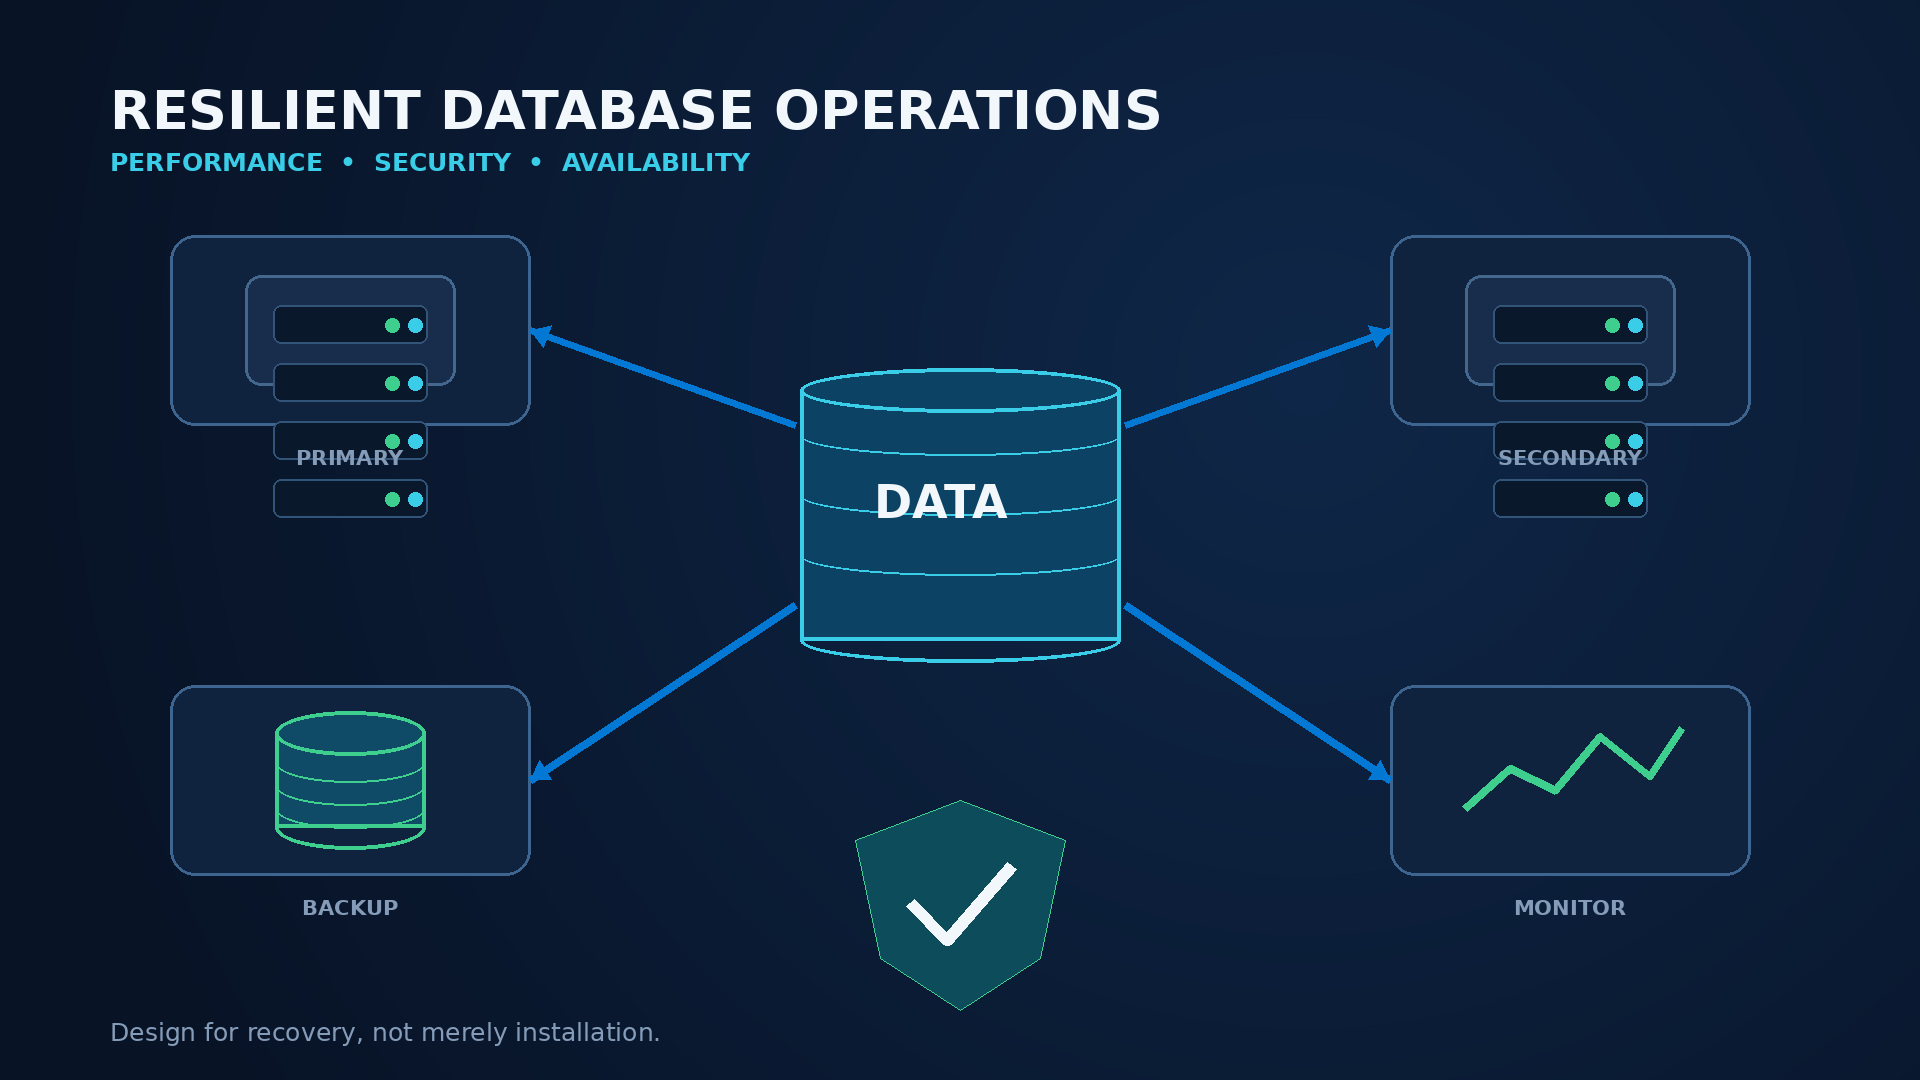
El rendimiento de la base de datos en Linux generalmente se gana o se pierde mediante una combinación de calidad de las consultas, presión de la memoria y latencia del almacenamiento. Datos separados, registros de transacciones, tempdb y copias de seguridad donde la arquitectura de almacenamiento puede proporcionar características de rendimiento o fallas genuinamente independientes. Simplemente crear cuatro directorios en el mismo dispositivo saturado proporciona orden organizacional, no cuatro rutas de E/S. Mida la latencia de lectura y escritura en las capas de SQL Server y del sistema operativo, incluso durante los picos de respaldo, punto de control y mantenimiento.
Establezca la memoria máxima del servidor de SQL Server para que el sistema operativo, los controladores y los agentes conserven suficiente memoria. Esté atento a los intercambios y a la presión sostenida de la memoria en lugar de depender de un único número de memoria libre. Alinee la topología de vCPU y el diseño NUMA con el hipervisor y la carga de trabajo. Las máquinas virtuales excesivamente anchas pueden tener penalizaciones en la programación, mientras que los sistemas de tamaño insuficiente crean colas ejecutables y una latencia inestable. Utilice estadísticas de espera reales, almacén de consultas y planes de ejecución para distinguir problemas de CPU, E/S, bloqueo, concesión de memoria y diseño de consultas.
SQL Server 2025 admite la colocación de tempdb en tmpfs. Esto puede resultar valioso para cargas de trabajo temporales adecuadas porque tmpfs está respaldado por memoria, pero es volátil, consume memoria y puede aumentar la presión en otros lugares. En esta disposición sólo se admite tempdb; nunca coloque allí bases de datos de usuarios o bases de datos persistentes del sistema. Mida su tamaño de manera conservadora, establezca el crecimiento de archivos deliberadamente, tenga en cuenta el comportamiento de reinicio y realice pruebas de carga en el peor escenario de derrame o almacenamiento de versiones. La guía de configuración de tmpfs debe seguirse exactamente.
El mantenimiento sigue siendo específico de la carga de trabajo. Actualice las estadísticas con una cadencia adecuada, administre el estado del índice en función del beneficio medido, mantenga útil la retención del Query Store y revise los costosos planes después de las actualizaciones. La conectividad ODBC genérica para PolyBase amplía las opciones de fuentes de datos externas en Linux, pero los escaneos remotos aún dependen de la calidad del controlador, la latencia de la red, la inserción de predicados y la capacidad de la fuente. Trate la federación como un diseño de integración, no como almacenamiento local gratuito.
Seguridad: aproveche Linux sin crear puntos ciegos
SQL Server 2025 en Linux habilita TLS 1.3 de forma predeterminada. Se trata de una base sólida, pero el cifrado no está completo hasta que los clientes validan el certificado del servidor y los administradores controlan la confianza. Utilice un certificado emitido para el nombre del servicio, proteja su clave privada, automatice la renovación de forma segura y pruebe los controladores más antiguos antes de que se apliquen cambios. Evite resolver errores de certificados configurando cada cliente para que confíe en cualquier certificado de servidor.
Prefiera identidades gobernadas centralmente donde la arquitectura de la aplicación las admita, utilice identidades de servicio independientes y otorgue los derechos mínimos de base de datos. SQL Server 2025 agrega políticas de contraseña personalizadas para inicios de sesión de SQL, útiles cuando no se puede eliminar la autenticación de SQL. Una política debe definir la duración, la complejidad, el historial, el bloqueo y la rotación en línea con el modelo de riesgo de la organización; no debería fomentar variaciones mensuales predecibles de contraseñas. Mantenga el acceso administrativo de emergencia protegido, auditado y probado.
En la capa de host, minimice los paquetes instalados, restrinja el inicio de sesión interactivo, mantenga limitada la membresía de sudo, aplique permisos de archivos y supervise los cambios en la configuración y los certificados. Utilice listas de firewall permitidas entre aplicaciones, administradores, nodos de clúster y sistemas de monitoreo. Mantenga SELinux o los controles obligatorios de la distribución en la configuración admitida en lugar de deshabilitar la protección para que una instalación "funcione". Envíe información de auditoría de SQL, fallas de autenticación, eventos de systemd y registros de seguridad del host a una plataforma central con retención adecuada para el negocio.
Alta disponibilidad: defina qué fallo quiere resolver
SQL Server en Linux admite instancias de clúster de conmutación por error y grupos de disponibilidad con orquestación basada en Pacemaker, pero resuelven diferentes problemas. Una FCI protege una instancia y normalmente depende del almacenamiento compartido. Un grupo de disponibilidad replica bases de datos de usuarios seleccionadas entre réplicas y puede proporcionar copias legibles o de recuperación ante desastres según la edición y la configuración. Ninguno reemplaza las copias de seguridad ni protege una aplicación si el DNS, la identidad, el quórum o una ruta de red compartida siguen siendo un único punto de falla.
Escriba primero los objetivos de recuperación. RTO describe qué tan rápido debería regresar el servicio; RPO describe cuánta pérdida de datos comprometida es aceptable. La replicación sincrónica puede reducir la pérdida de datos en el sobre de falla previsto, pero agrega latencia y aún requiere una política de conmutación por error correcta. La replicación asincrónica suele ser mejor para sitios de recuperación de desastres distantes, ya que se acepta una posible brecha de datos. Documente si la conmutación por error es automática o manual, qué bases de datos se mueven juntas, cómo se sincronizan los inicios de sesión y los trabajos, y cómo las aplicaciones descubren el nuevo primario.
Pacemaker necesita quórum, mecanismos de fencing y agentes de recursos probados. El vallado no es una decoración opcional: evita que dos nodos crean que poseen el mismo servicio o almacenamiento. Coloque nodos y testigos en dominios de falla significativos, mantenga el tiempo sincronizado y ensaye la pérdida de un nodo, segmento de red, ruta de almacenamiento y testigo. La edición estándar tiene capacidades de grupo de disponibilidad más limitadas que la Enterprise, por lo que debe verificar los límites exactos de las funciones antes de prometer una topología. La descripción general del grupo de disponibilidad de Linux es un punto de partida, no un sustituto de un runbook.
Copias de seguridad: el producto real es la recuperación
Una tarea de copia de seguridad que termina correctamente es solo una entrada para la capacidad de recuperación. Definir cronogramas completos, diferenciales y de registro de transacciones del RPO; elegir la retención entre las necesidades operativas, contractuales y regulatorias; cifrar copias de seguridad; y almacenar copias fuera del host de la base de datos y fuera del dominio de falla principal. Proteja las credenciales de respaldo por separado de las credenciales del administrador de la base de datos para que un compromiso no borre tanto las copias de producción como las de recuperación.
Utilice copias de seguridad nativas de SQL Server para una recuperación coherente con la base de datos. Las instantáneas de la infraestructura pueden complementarlas cuando se coordinan y son compatibles, pero una imagen de disco consistente con fallas no reemplaza automáticamente una cadena de respaldo de base de datos probada. Supervise la antigüedad, la duración, el rendimiento y los fallos de las copias de seguridad. Verifique las sumas de comprobación cuando corresponda, ejecute comprobaciones de integridad y mantenga suficiente espacio libre para restauraciones de emergencia.
Las pruebas de restauración deben programarse, medirse y documentarse. Restaure a un entorno limpio, recupere hasta un momento elegido, ejecute comprobaciones de integridad, verifique el acceso de los usuarios y las aplicaciones y compare el RTO logrado con el objetivo. Pruebe también la clave de copia de seguridad cifrada y la recuperación de certificados. La Guía de copia de seguridad y restauración de Microsoft para Linux cubre las mecánicas admitidas; la organización debe agregar propiedad, retención y ensayo.
Supervisión: correlacione las señales de SQL Server y Linux
Monitorear desde la transacción del usuario hacia abajo. Los indicadores de nivel de servicio pueden incluir solicitudes exitosas, latencia y tasa de error. Las señales de SQL Server incluyen esperas, bloqueos, interbloqueos, compilaciones, regresiones del almacén de consultas, uso de registros, estado de la base de datos, colas AG, antigüedad de las copias de seguridad y fallas en los trabajos. Las señales de Linux incluyen presión de la CPU, cola de ejecución, presión de la memoria, intercambio, capacidad del sistema de archivos, latencia de E/S, errores de red y reinicios del sistema. Las implementaciones de contenedores agregan eventos de limitación, desalojo, volumen y programación.
Centralice el registro de errores de SQL Server y las entradas de diario relevantes, pero no recopile secretos ni textos de consulta confidenciales completos de forma indiscriminada. Mantenga el tiempo sincronizado para que los eventos puedan correlacionarse entre aplicaciones, servidores proxy, SQL Server, Pacemaker y almacenamiento. Revise el monitoreo después de cada incidente: si los respondedores tuvieron que inventar una consulta o comando bajo presión, agréguelo al panel o runbook.
Migración a SQL Server 2025 en Linux
Una migración en paralelo suele ser más segura que tratar un cambio de sistema operativo como una actualización rutinaria local. Bases de datos de inventario, niveles de compatibilidad, intercalaciones, trabajos del Agente SQL, servidores vinculados, componentes CLR, rutas de archivos, certificados, credenciales, replicación, fuentes de datos externas, controladores y scripts operativos. Identifique dependencias de Windows, como letras de unidades, cuentas locales de Windows, suposiciones de archivos que no distinguen entre mayúsculas y minúsculas, trabajos exclusivos de PowerShell o componentes no compatibles. Clasifique cada elemento como portátil, reemplazable, que requiere rediseño o candidato a retiro.
Utilice una restauración de prueba representativa en el objetivo de manera temprana. Ejecute comprobaciones de coherencia de la base de datos, actualice los asesores cuando corresponda, pruebas de aplicaciones y líneas de base de rendimiento. Mantenga el nivel de compatibilidad original inicialmente si eso reduce el cambio, luego evalúe el comportamiento del optimizador 2025 con evidencia de Query Store. Valide cuidadosamente la intercalación y el comportamiento de los casos: las rutas de Linux distinguen entre mayúsculas y minúsculas incluso cuando la intercalación de una base de datos no lo hace.
Para bases de datos pequeñas con una interrupción aceptable, realizar una copia de seguridad, copiar, restaurar y redirigir puede ser suficiente. Las migraciones de mayor tamaño o con tiempo de inactividad reducido pueden utilizar patrones de envío de registros, grupos de disponibilidad, replicación u otros métodos de movimiento de datos admitidos, según la versión y edición de origen. Cada enfoque necesita un plan de transición con congelación de escritura, sincronización final, validación, cambio de cadena de conexión, cierre de sesión comercial y límite de reversión. No desmantele la fuente hasta que las copias de seguridad, la observabilidad y un período operativo estable confirmen el nuevo servicio.
Licenciar SQL Server 2025 Standard de forma responsable
Empiece por separar la selección de ediciones, los límites técnicos y los derechos de licencia. El estándar puede ser una buena opción para muchas cargas de trabajo departamentales y de tamaño mediano, pero su techo de cómputo de 32 núcleos por instancia y sus límites de características deben ajustarse al diseño. Microsoft ofrece diferentes modelos de licencias y reglas de virtualización; el cálculo correcto depende de los núcleos físicos, las máquinas virtuales, el patrón de acceso y los derechos asociados a la licencia. Revise la guía de licencia de Microsoft SQL Server y los términos del producto actuales para tomar la decisión final.
Licendi ofrece una licencia legítima de SQL Server 2025 Standard de segunda mano para organizaciones que buscan una ruta de licencia perpetua. Una revisión de compra responsable debe preservar la factura, la descripción del producto, la documentación de la licencia y la evidencia de transferencia/procedencia proporcionada para la transacción. Confirme que la cantidad, la edición, la métrica y la topología de implementación coincidan con el diseño técnico antes de la compra y nuevamente antes de la activación de la producción.
Las licencias de segunda mano pueden ser una opción de adquisición válida en jurisdicciones relevantes, pero no es motivo para adivinar. Los clústeres complejos, los acuerdos de alojamiento, la movilidad en la nube, el movimiento frecuente de máquinas virtuales o los entornos físicos/virtuales mixtos merecen una revisión especializada. Mantenga registros de licencias con el inventario de configuración para que los cambios en la infraestructura activen una verificación de cumplimiento en lugar de depender de una hoja de cálculo descubierta durante una auditoría.
Lista práctica de despliegue
Arquitectura y soporte
- Registre el propietario del negocio, el propietario técnico, la clasificación de datos, RTO y RPO.
- Seleccione el host nativo, la máquina virtual o el contenedor en función de las operaciones y la recuperación, no de la moda.
- Elija RHEL 9/10 o Ubuntu 22.04/24.04 y XFS o ext4.
- Registre la edición de SQL Server, la compilación de CU, la compilación del sistema operativo, el kernel y el resumen de imágenes.
- Confirme cada controlador crítico, se admite la extensión, el componente de clúster y el agente de respaldo.
- Verifique que el techo de cómputo de 32 núcleos de Standard se ajuste a la instancia.
Construcción y seguridad
- Automatice la configuración del repositorio, la instalación de paquetes y las configuraciones aprobadas.
- Recuperar secretos de una bóveda; manténgalos fuera de scripts, imágenes e historial de shell.
- Instale un certificado de servicio y pruebe TLS 1.3 con controladores de cliente de producción.
- Restringa las reglas de firewall, sudo, propiedad de archivos y acceso interactivo.
- Habilite la auditoría requerida y reenvíe la base de datos y aloje los eventos de seguridad de manera centralizada.
- Documente el ciclo recurrente de parches de sistema operativo, CU, controlador e imagen de contenedor.
Rendimiento y datos
- Tamaño de los picos de carga de trabajo, crecimiento y mantenimiento medidos.
- Reserva memoria y espacio de CPU para Linux y agentes operativos.
- Valida la latencia y durabilidad de los datos, registros, tempdb y almacenamiento de respaldo.
- Establece deliberadamente la memoria máxima del servidor y el crecimiento de archivos.
- Utiliza tmpfs solo para tempdb, con una capacidad probada y un plan de reinicio.
- Captura un almacén de consultas y un sistema operativo de preproducción línea de base.
Disponibilidad y recuperación
- Asignar dominios de falla y eliminar dependencias compartidas accidentales.
- Configurar políticas de quórum, cercado, escucha/DNS y conmutación por error de manera explícita.
- Probar escenarios de falla de nodo, red, almacenamiento, testigo y réplica.
- Cifrar copias de seguridad y mantener copias fuera del dominio de falla principal.
- Realizar y cronometrar una restauración limpia, incluidas claves y recuperación en un momento dado.
- Escribir runbooks de reconexión, conmutación por error, escalamiento y reversión de aplicaciones.
Operaciones y licencias
- Alerta sobre el impacto del usuario, esperas de SQL, bloqueo, capacidad, estado de AG y antigüedad de la copia de seguridad.
- Correlaciona SQL, systemd, SO, contenedor, clúster y telemetría de almacenamiento.
- Asigna un propietario y una primera acción a cada elemento crítico alerta.
- Inventario de trabajos, inicios de sesión, certificados, controladores y dependencias antes de la migración.
- Validar el modelo de licencia, métricas, cantidades, evidencia y topología.
- Programar una revisión posterior al lanzamiento del rendimiento, la seguridad, la recuperación y el cumplimiento.
Conclusión
SQL Server 2025 en Linux tiene más éxito cuando se opera como un servicio de base de datos, no simplemente instalado como otro paquete. Las plataformas compatibles, una base de CU precisa, un almacenamiento duradero, controles cuidadosos de recursos, validación de certificados, recuperación ensayada y monitoreo útil son todas partes del mismo diseño. Linux brinda a los equipos bases sólidas de automatización y observabilidad; SQL Server agrega sus propias responsabilidades de estado, transacciones y licencias.
Preguntas frecuentes
¿Qué distribuciones de Linux admiten SQL Server 2025?
Microsoft admite instalaciones nativas en RHEL 9 y 10 y Ubuntu 22.04 y 24.04, usando XFS o ext4. RHEL 10 y Ubuntu 24.04 son totalmente compatibles desde CU1.
¿SQL Server 2025 es compatible con SLES?
No. SLES no es una plataforma SQL Server 2025 compatible. Migre una instancia antigua alojada en SLES a un destino RHEL o Ubuntu compatible, normalmente a través de un plan de restauración y copia de seguridad en paralelo.
¿Cuál es la última actualización de Linux de SQL Server 2025?
A partir del 31 de julio de 2026, es CU7, compilación 17.0.4065.4, lanzada el 16 de julio de 2026. Siempre vuelva a verificar las notas de la versión antes implementación.
¿Se puede ejecutar SQL Server 2025 en un contenedor de Linux?
Sí, en hosts Linux x86-64 compatibles que utilicen procesadores Intel o AMD. Mantenga el almacenamiento de la base de datos, fije la versión de la imagen, proteja los secretos y pruebe la copia de seguridad y la recuperación fuera del contenedor.
¿Puedo colocar bases de datos de SQL Server en tmpfs?
Solo tempdb es compatible con tmpfs. Es volátil y está respaldado por memoria, así que dimensione y pruébelo con cuidado. Las bases de datos de usuario y las bases de datos persistentes del sistema deben permanecer en un almacenamiento duradero y compatible.
¿La edición estándar utiliza más de 32 núcleos?
Una instancia del motor de base de datos estándar está limitada a cuatro sockets o 32 núcleos, el menor. Aún es necesario verificar las reglas de licencia y virtualización para la implementación real.
¿Los grupos de disponibilidad reemplazan las copias de seguridad?
No. La replicación puede mejorar la disponibilidad, pero también puede reproducir la eliminación o la corrupción. Mantenga copias de seguridad cifradas independientes y realice pruebas de restauración programadas.
¿Es legítima una licencia de SQL Server de segunda mano?
Puede ser una ruta de adquisición legítima donde se cumplen las condiciones legales y de transferencia de licencia. Conserve los documentos de transacciones y procedencia y valide la edición, la métrica y la topología para la implementación prevista.




