 PT
 EN
 FR
 DE
 IT
 ES


SQL Server 2025 em Linux: guia prático de implementação
Executar o SQL Server no Linux não é mais uma alternativa experimental. Para organizações que já padronizam o Red Hat Enterprise Linux ou Ubuntu, o SQL Server 2025 torna possível manter ferramentas de banco de dados familiares enquanto integra o mecanismo a um modelo operacional Linux estabelecido. A vantagem não consiste apenas em evitar o Windows. É a capacidade de usar a mesma automação, observabilidade, plataformas de contêiner, controles de segurança e habilidades de infraestrutura que já dão suporte ao restante do conjunto de aplicativos.
Essa flexibilidade não elimina as decisões arquitetônicas. Uma implantação de produção confiável ainda depende da escolha de uma distribuição compatível, da aplicação da atualização cumulativa correta, do dimensionamento deliberado do armazenamento e da memória, da proteção de segredos, do teste de recuperação e da correspondência da topologia com a edição e licença corretas. Este guia segue esse caminho desde a primeira reunião de design até a lista de verificação operacional.
Comece por uma versão de referência precisa
O SQL Server 2025, a geração 17.x, tornou-se disponível em 18 de novembro de 2025. Em 31 de julho de 2026, a atualização cumulativa mais recente é CU7, lançada em 16 de julho de 2026, com número de compilação 17.0.4065.4. Essas datas são importantes porque o “SQL Server 2025” não é uma linha de base de produção suficientemente precisa. Os registros de instalação, o gerenciamento de configuração e os relatórios de incidentes devem nomear a edição, a compilação, a distribuição do Linux, o kernel e o resumo da imagem do contêiner, quando aplicável.
As atualizações cumulativas da Microsoft são cumulativas: uma nova instalação normalmente pode ser movida diretamente para a CU atual em vez de aplicar todos os pacotes anteriores. No entanto, uma atualização deve passar primeiro por um ambiente representativo de não produção. Teste a conectividade de aplicativos, trabalhos do SQL Agent, backup e restauração, comportamento de grupo de disponibilidade, extensões, drivers e monitoramento. Mantenha uma rota de reversão ou recuperação acordada. As notas de versão oficiais do SQL Server 2025 Linux são o lugar certo para confirmar compilações atuais e problemas conhecidos antes de uma janela de manutenção.
Escolha o modelo operacional antes dos comandos
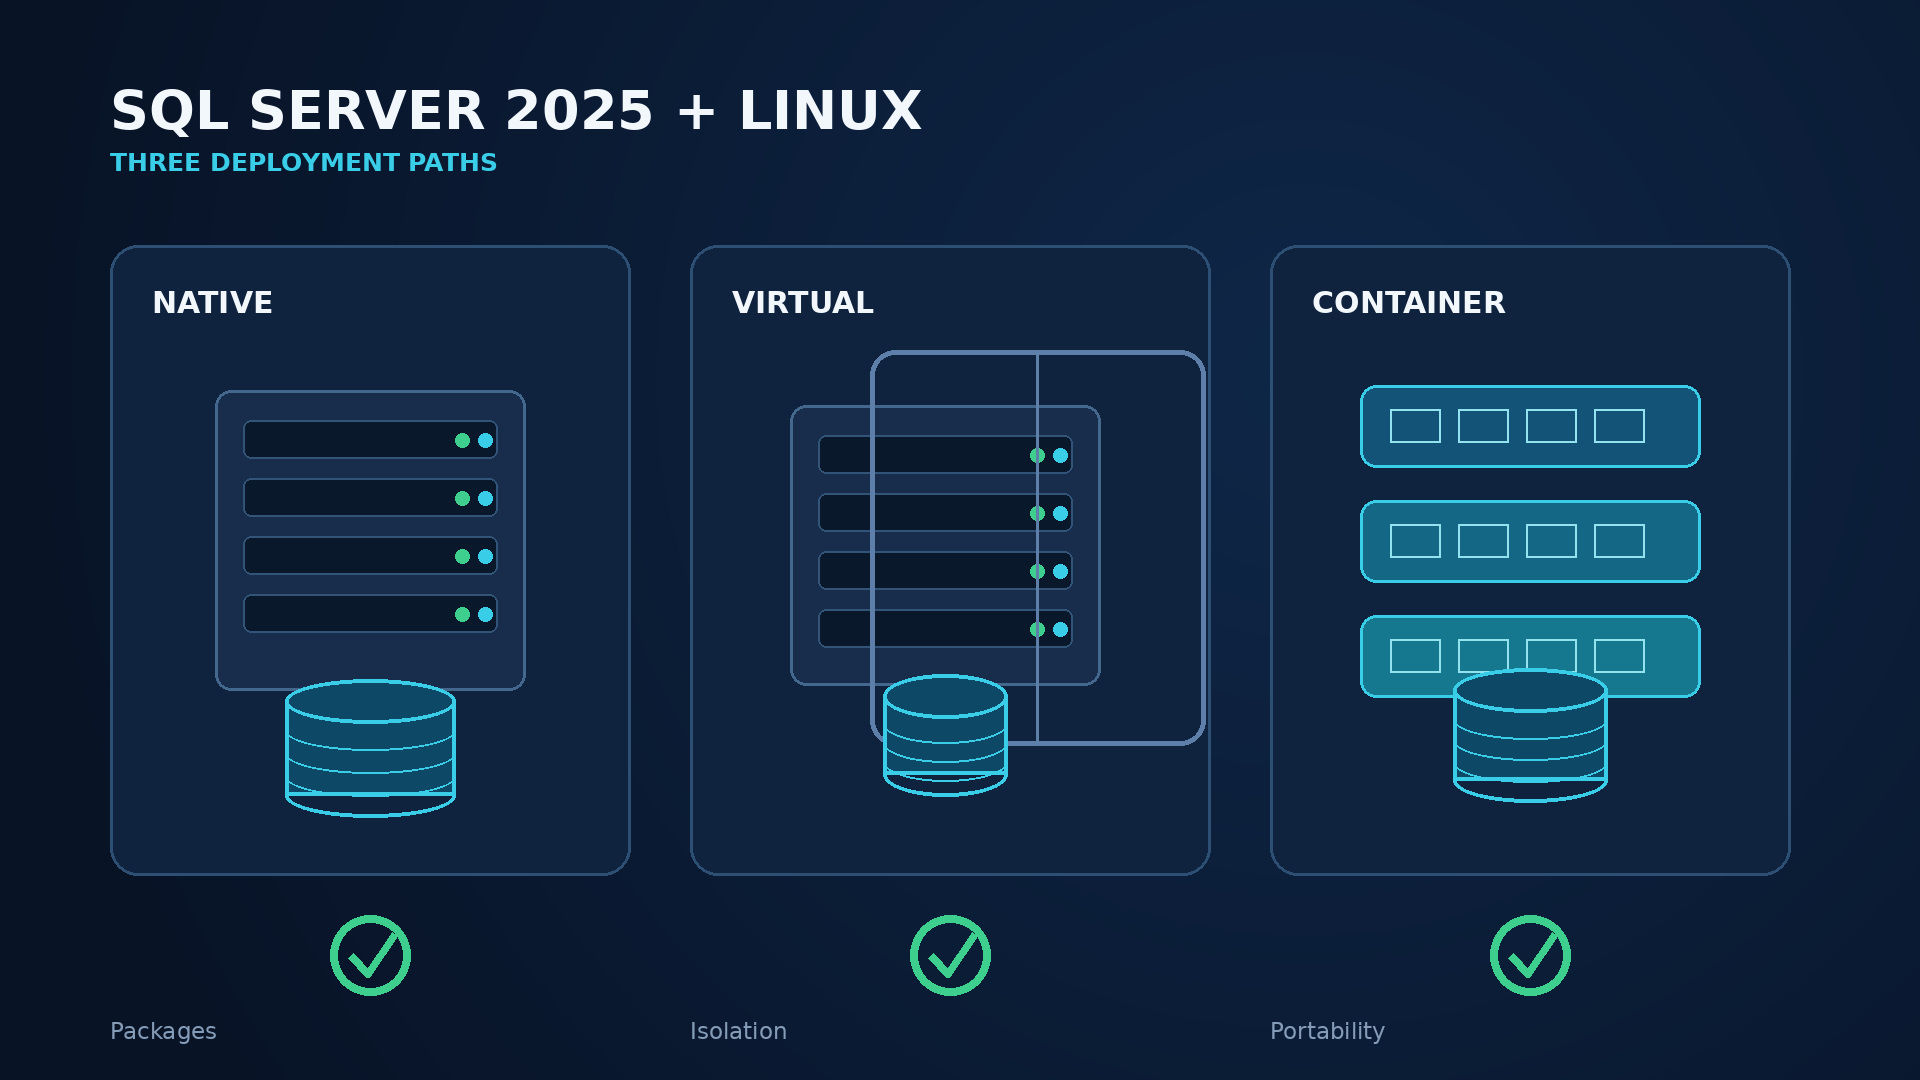
Existem quatro padrões comuns. Uma instalação de pacote nativo coloca o SQL Server diretamente em um servidor Linux ou máquina virtual compatível. Ele oferece integração direta com o sistema e geralmente é a escolha mais clara para hosts de banco de dados estáveis e de longa duração. Uma máquina virtual adiciona isolamento de infraestrutura, instantâneos para fluxos de trabalho de infraestrutura e opções familiares de recuperação de desastres, mas o banco de dados ainda precisa de backup e recuperação com reconhecimento de SQL. Um contêiner empacota o mecanismo e as dependências em um artefato repetível, deixando persistência, segredos e orquestração para a plataforma. Um banco de dados em nuvem gerenciado transfere mais responsabilidade operacional para um provedor, embora não seja o mesmo produto ou superfície de controle que uma instância Linux autogerenciada.
Não escolha contêineres apenas porque a equipe do aplicativo usa Kubernetes. Os bancos de dados têm estado durável, objetivos de recuperação e requisitos de latência. Por outro lado, não rejeite contêineres porque eles são efêmeros: o contêiner pode ser substituído enquanto os dados, logs, backups e configuração persistem corretamente. A decisão deve ser baseada na capacidade da equipe, na padronização, nos requisitos de alta disponibilidade, na integração de armazenamento, no processo de patch e no grau de controle necessário no nível do host.
| Modelo | Melhor ajuste | Carga de design principal |
|---|---|---|
| Host nativo ou VM | Serviço de banco de dados previsível e de longa duração | Ciclo de vida do sistema operacional, aplicação de patches e HA do host |
| Contêiner | Implantação repetível com plataforma madura engenharia | Armazenamento persistente, segredos, agendamento e recuperação |
| Serviço gerenciado | Equipes que preferem infraestrutura operada pelo provedor | Restrições de serviço, ajuste de migração e modelo recorrente |
Plataformas Linux suportadas: uma lista curta por bons motivos
Para uma instalação nativa do SQL Server 2025, a Microsoft oferece suporte RHEL 9 e 10 e Ubuntu 22.04 e 24.04, usando XFS ou ext4. RHEL 10 e Ubuntu 24.04 eram opções de visualização em disponibilidade geral e tornaram-se totalmente compatíveis a partir de CU1 em 29 de janeiro de 2026. SUSE Linux Enterprise Server não é compatível com SQL Server 2025. Se uma instância mais antiga do SQL Server estiver sendo executada atualmente no SLES, atualizar os binários em vigor não é o caminho para 2025; planeje uma mudança lado a lado, normalmente fazendo backup e restaurando bancos de dados para um destino compatível.
A matriz de suporte é um limite de engenharia, não uma sugestão. Uma distribuição que pode tecnicamente instalar um RPM ou executar um processo não é automaticamente uma plataforma de produção suportada. Fixe a versão de distribuição principal escolhida no registro de arquitetura e confirme-a com as orientações atuais de configuração do Linux da Microsoft. Verifique também a posição de suporte da camada de virtualização, driver de armazenamento, pilha de cluster e agente de backup. O banco de dados pode ser suportado, enquanto um componente essencial circundante não.
Planeie a capacidade e a topologia antes da instalação
Comece com evidências de carga de trabalho: pico de transações por segundo, sessões simultâneas, crescimento do banco de dados, combinação de leitura/gravação, tamanho do conjunto de trabalho, maiores consultas, janelas de lote e objetivos de recuperação. Os requisitos mínimos de instalação não descrevem um servidor de produção íntegro. O SQL Server compete por CPU, memória e E/S com o kernel, agentes de segurança, software de backup e monitoramento. Deixe espaço explícito em vez de atribuir todos os recursos ao banco de dados.
Separe a capacidade da disponibilidade. Uma VM grande não está altamente disponível apenas porque possui muitos núcleos. Um cluster de dois nós não será resiliente se ambos os nós, seu armazenamento e seu quorum dependerem de um domínio de falha. Desenhe as dependências: hosts de computação, racks ou zonas, DNS, identidade, serviço de horário, caminhos de rede, armazenamento, testemunha, destino de backup e plano de gerenciamento. Em seguida, marque quais falhas o design pode tolerar e como ele se recupera das demais.
Para o SQL Server Standard, observe o limite de capacidade de computação: uma instância do Mecanismo de Banco de Dados pode usar o menor entre quatro soquetes ou 32 núcleos. O guia de licenciamento também expressa o limite Padrão como 32 núcleos licenciados. Adicionar vCPUs além do limite suportado não transforma Padrão em Empresarial e pode complicar custos e conformidade. Se a carga de trabalho realmente exigir mais computação, operações on-line avançadas ou recursos de alta disponibilidade mais amplos, compare o Enterprise antes de finalizar a plataforma.
Instalação nativa no RHEL ou Ubuntu
Uma compilação de produção deve ser automatizada, mas os administradores devem entender o que a automação faz. O fluxo de trabalho típico é provisionar um sistema operacional compatível, corrigi-lo, configurar o DNS e a sincronização de horário, montar volumes de dados, adicionar o repositório de pacotes assinados pela Microsoft, instalar o pacote mssql-server, executar a configuração inicial, selecionar a edição, aceitar os termos, definir a credencial de administrador do sistema com segurança e iniciar o serviço systemd. Ferramentas cliente como sqlcmd podem ser instaladas separadamente em hosts administrativos.
Não coloque uma senha de administrador real no histórico do shell, nos logs de inicialização da nuvem ou em um repositório de configuração. Use o gerenciador de segredos da organização e um processo de inicialização controlado. Após a configuração, verifique systemctl status mssql-server, revise o log de erros do SQL Server, conecte-se localmente com criptografia e consulte SERVERPROPERTY('ProductVersion'), SERVERPROPERTY('Edition') e os caminhos de dados configurados. Aplique a CU aprovada antes de integrar os dados de produção.
Mova dados padrão e diretórios de log somente por meio de configuração documentada do SQL Server, e não improvisando links simbólicos. Defina propriedade e permissões de forma restrita para a conta mssql. Abra o TCP 1433 somente quando necessário; uma porta padrão exposta a uma rede inteira não é uma conquista de implantação. Defina explicitamente fontes de firewall, rotas de gerenciamento e cadeias de conexão de aplicativos. Por fim, registre todas as configurações mssql-conf não padrão na documentação de infraestrutura controlada por versão.
Contentores: repetível não significa dados descartáveis
A Microsoft oferece suporte a imagens de contêiner do SQL Server 2025 em hosts Linux x86-64 com processadores Intel ou AMD. Ambientes de tradução e emulação como Rosetta 2, Prism e QEMU não são testados nem suportados. Fixe uma imagem de produção em uma tag CU aprovada e, de preferência, em um resumo imutável; usar uma tag flutuante torna difícil provar o que mudou entre as reinicializações.
O contêiner deve ser executado como um usuário não-root, receber seu segredo por meio do orquestrador ou armazenamento secreto e usar armazenamento persistente para /var/opt/mssql ou um layout de dados deliberadamente separado. Valide a classe de armazenamento para latência, taxa de transferência, comportamento fsync, anexo de failover e instantâneos. Um volume que funciona para um cache da web pode ser inadequado para um log de transações com muitas gravações. Defina solicitações e limites de CPU e memória com espaço medido. O SQL Server 2025 entende o cgroup v2, melhorando o reconhecimento dos recursos atribuídos pelo Linux moderno e pelas plataformas de contêiner, mas limites fracos ainda produzem desempenho ruim.
As verificações de integridade devem distinguir “o processo existe” de “o banco de dados aceita trabalho útil”. Adicione permissão de inicialização para recuperação de falhas, evite loops de reinicialização que interrompem a recuperação e drene o tráfego do aplicativo antes da substituição planejada do pod. Os backups devem sair do domínio de falha do contêiner. Teste restaurá-los para uma instância limpa criada a partir da mesma imagem e configuração documentadas.
Desempenho: projete primeiro o caminho de E/S
O desempenho do banco de dados no Linux geralmente é ganho ou perdido por meio de uma combinação de qualidade de consulta, pressão de memória e latência de armazenamento. Dados separados, logs de transações, tempdb e backups onde a arquitetura de armazenamento pode fornecer desempenho genuinamente independente ou características de falha. A simples criação de quatro diretórios no mesmo dispositivo saturado proporciona organização organizacional, e não quatro caminhos de E/S. Meça a latência de leitura e gravação nas camadas do SQL Server e do sistema operacional, inclusive durante picos de backup, pontos de verificação e manutenção.
Defina a memória máxima do servidor SQL Server para que o sistema operacional, os drivers e os agentes retenham memória suficiente. Fique atento à troca e à pressão sustentada da memória, em vez de depender de um único número de memória livre. Alinhe a topologia vCPU e o design NUMA com o hipervisor e a carga de trabalho. VMs excessivamente largas podem ter penalidades de agendamento, enquanto sistemas subdimensionados criam filas executáveis e latência instável. Use estatísticas de espera reais, armazenamento de consultas e planos de execução para distinguir problemas de CPU, E/S, bloqueio, concessão de memória e design de consulta.
O SQL Server 2025 oferece suporte à colocação de tempdb em tmpfs. Isso pode ser valioso para cargas de trabalho temporárias adequadas porque o tmpfs é baseado em memória, mas é volátil, consome memória e pode aumentar a pressão em outros lugares. Apenas tempdb é suportado neste arranjo; nunca coloque bancos de dados de usuários ou bancos de dados de sistema persistentes lá. Dimensione-o de forma conservadora, defina o crescimento do arquivo deliberadamente, considere o comportamento de reinicialização e teste de carga o pior cenário de vazamento ou armazenamento de versão. As orientações de configuração do tmpfs devem ser seguidas exatamente.
A manutenção permanece específica da carga de trabalho. Atualize as estatísticas em uma cadência apropriada, gerencie a integridade do índice com base nos benefícios medidos, mantenha a retenção do Query Store útil e revise planos caros após as atualizações. A conectividade ODBC genérica para PolyBase expande as opções de fontes de dados externas no Linux, mas as verificações remotas ainda dependem da qualidade do driver, da latência da rede, do pushdown de predicados e da capacidade da fonte. Trate a federação como um design de integração, não como armazenamento local gratuito.
Segurança: tire partido do Linux sem criar pontos cegos
O SQL Server 2025 no Linux habilita o TLS 1.3 por padrão. Essa é uma linha de base sólida, mas a criptografia não está completa até que os clientes validem o certificado do servidor e os administradores controlem a confiança. Use um certificado emitido para o nome do serviço, proteja sua chave privada, automatize a renovação com segurança e teste drivers mais antigos antes de alterações na aplicação. Evite resolver erros de certificado configurando cada cliente para confiar em qualquer certificado de servidor.
Prefira identidades governadas centralmente onde a arquitetura do aplicativo as suporte, use identidades de serviço separadas e conceda os direitos mínimos de banco de dados. O SQL Server 2025 adiciona políticas de senha personalizadas para logins SQL, úteis onde a autenticação SQL não pode ser removida. Uma política deve definir extensão, complexidade, histórico, bloqueio e rotação de acordo com o modelo de risco da organização; não deve encorajar variações mensais previsíveis de senha. Mantenha o acesso administrativo de emergência protegido, auditado e testado.
Na camada do host, minimize os pacotes instalados, restrinja o logon interativo, mantenha a associação ao sudo restrita, aplique permissões de arquivo e monitore alterações na configuração e nos certificados. Use listas de permissões de firewall entre aplicativos, administradores, nós de cluster e sistemas de monitoramento. Mantenha o SELinux ou os controles obrigatórios da distribuição na configuração suportada em vez de desabilitar a proteção para fazer uma instalação “funcionar”. Envie informações de auditoria SQL, falhas de autenticação, eventos do systemd e logs de segurança do host para uma plataforma central com retenção apropriada ao negócio.
A aplicação de patches faz parte à segurança e à confiabilidade. Mantenha um ciclo recorrente para o kernel Linux, SQL Server CU, drivers, ferramentas de linha de comando, software de backup e imagem base do contêiner. Defina quais atualizações exigem reinicialização ou failover, quem valida o serviço posteriormente e quais evidências fecham a mudança. A verificação de vulnerabilidades deve entender a diferença entre uma camada de imagem, um pacote instalado e um processo de banco de dados corrigido e em execução.
Alta disponibilidade: defina a falha que pretende resolver
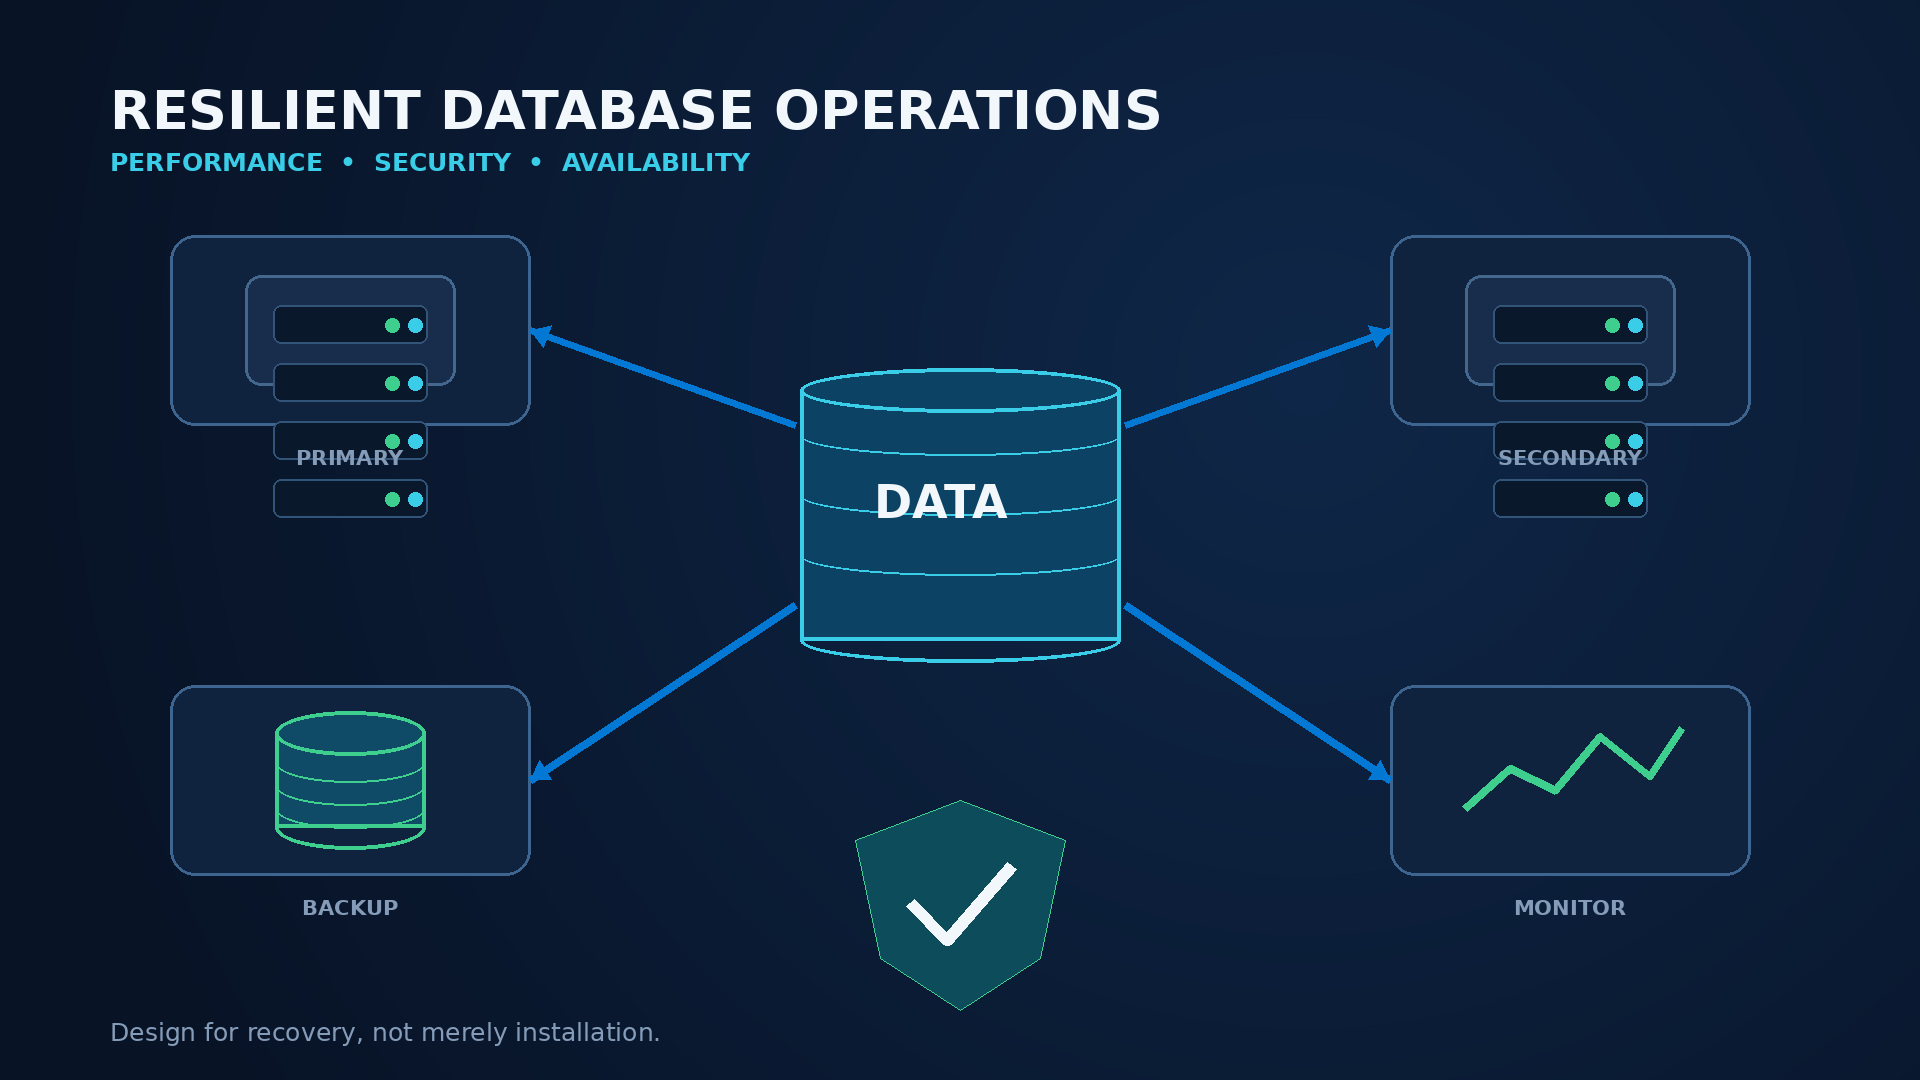
O SQL Server no Linux oferece suporte a instâncias de cluster de failover e grupos de disponibilidade com orquestração baseada em Pacemaker, mas eles resolvem problemas diferentes. Uma FCI protege uma instância e normalmente depende de armazenamento compartilhado. Um grupo de disponibilidade replica bancos de dados de usuários selecionados entre réplicas e pode fornecer cópias legíveis ou de recuperação de desastres, dependendo da edição e da configuração. Nenhum dos dois substitui os backups e nenhum protege um aplicativo se o DNS, a identidade, o quorum ou um caminho de rede compartilhado continuarem sendo um ponto único de falha.
Escreva primeiro os objetivos de recuperação. O RTO descreve a rapidez com que o serviço deve retornar; O RPO descreve o quanto a perda de dados comprometida é aceitável. A replicação síncrona pode reduzir a perda de dados no envelope de falha pretendido, mas adiciona latência e ainda requer uma política de failover correta. A replicação assíncrona costuma ser melhor para locais distantes de recuperação de desastres, aceitando uma potencial lacuna de dados. Documente se o failover é automático ou manual, quais bancos de dados se movem juntos, como os logins e jobs são sincronizados e como os aplicativos descobrem o novo primário.
O Pacemaker precisa de quorum, fencing e agentes de recursos testados. A cerca não é uma decoração opcional: evita que dois nós acreditem que possuem o mesmo serviço ou armazenamento. Coloque nós e testemunhas em domínios de falha significativos, mantenha o tempo sincronizado e ensaie a perda de um nó, segmento de rede, caminho de armazenamento e testemunha. A edição Standard tem recursos de grupo de disponibilidade mais restritos que a Enterprise, portanto, verifique os limites exatos dos recursos antes de prometer uma topologia. A visão geral do grupo de disponibilidade do Linux é um ponto de partida, não um substituto para um runbook.
Cópias de segurança: o verdadeiro produto é a recuperação
Uma tarefa de cópia de segurança concluída com sucesso é apenas uma entrada para a recuperabilidade. Definir cronogramas completos, diferenciais e de log de transações do RPO; escolher a retenção de acordo com as necessidades operacionais, contratuais e regulatórias; criptografar backups; e armazenar cópias fora do host do banco de dados e fora do domínio de falha primário. Proteja as credenciais de backup separadamente das credenciais de administrador de banco de dados para que um comprometimento não apague as cópias de produção e de recuperação.
Use backups nativos do SQL Server para recuperação consistente com o banco de dados. Os snapshots de infraestrutura podem complementá-los quando coordenados e suportados, mas uma imagem de disco consistente com falhas não substitui automaticamente uma cadeia de backup de banco de dados testada. Monitore a idade, a duração, o rendimento e as falhas do backup. Verifique as somas de verificação quando apropriado, execute verificações de integridade e mantenha espaço livre suficiente para restaurações de emergência.
Os testes de restauração devem ser agendados, medidos e documentados. Restaure para um ambiente limpo, recupere até um ponto escolhido no tempo, execute verificações de integridade, verifique o acesso de usuários e aplicativos e compare o RTO alcançado com o objetivo. Teste também a chave de backup criptografada e a recuperação de certificado. O guia de backup e restauração da Microsoft para Linux aborda a mecânica suportada; a organização deve adicionar propriedade, retenção e ensaio.
Monitorização: correlacione os sinais do SQL Server e do Linux
Monitorar desde a transação do usuário até o final. Os indicadores de nível de serviço podem incluir solicitações bem-sucedidas, latência e taxa de erros. Os sinais do SQL Server incluem esperas, bloqueios, deadlocks, compilações, regressões do Query Store, uso de log, estado do banco de dados, filas AG, idade do backup e falhas de trabalho. Os sinais do Linux incluem pressão da CPU, fila de execução, pressão da memória, troca, capacidade do sistema de arquivos, latência de E/S, erros de rede e reinicializações do systemd. As implantações de contêineres adicionam eventos de limitação, remoção, volume e agendador.
Centralize o log de erros do SQL Server e as entradas de diário relevantes, mas não colete segredos ou textos de consulta confidenciais completos indiscriminadamente. Mantenha o tempo sincronizado para que os eventos possam ser correlacionados entre aplicativos, proxies, SQL Server, Pacemaker e armazenamento. Revise o monitoramento após cada incidente: se os respondentes tiveram que inventar uma consulta ou comando sob pressão, adicione-o ao painel ou runbook.
Migrar para o SQL Server 2025 em Linux
Uma migração lado a lado geralmente é mais segura do que tratar uma alteração no sistema operacional como uma atualização local de rotina. Bancos de dados de inventário, níveis de compatibilidade, agrupamentos, trabalhos do SQL Agent, servidores vinculados, componentes CLR, caminhos de arquivos, certificados, credenciais, replicação, fontes de dados externas, drivers e scripts operacionais. Identifique dependências do Windows, como letras de unidade, contas locais do Windows, suposições de arquivos que não diferenciam maiúsculas de minúsculas, trabalhos somente do PowerShell ou componentes sem suporte. Classifique cada item como portátil, substituível, com necessidade de reprojeto ou candidato a aposentadoria.
Use uma restauração de teste representativa no destino antecipadamente. Execute verificações de consistência de banco de dados, atualize orientadores quando aplicável, testes de aplicativos e linhas de base de desempenho. Mantenha inicialmente o nível de compatibilidade original se isso reduzir as alterações e, em seguida, avalie o comportamento do otimizador 2025 com evidências do Query Store. Valide cuidadosamente o agrupamento e o comportamento de maiúsculas e minúsculas: os caminhos do Linux diferenciam maiúsculas de minúsculas, mesmo quando um agrupamento de banco de dados não o faz.
Para bancos de dados pequenos com uma interrupção aceitável, backup, cópia, restauração e redirecionamento podem ser suficientes. Migrações maiores ou com baixo tempo de inatividade podem usar padrões de envio de logs, grupos de disponibilidade, replicação ou outros métodos de movimentação de dados com suporte, dependendo da versão e edição de origem. Cada abordagem precisa de um plano de transição com congelamento de gravação, sincronização final, validação, alteração da cadeia de conexão, aprovação de negócios e limite de reversão. Não desmonte a fonte até que os backups, a observabilidade e um período operacional estável confirmem o novo serviço.
Licenciar o SQL Server 2025 Standard de forma responsável
Comece separando a seleção de edição, limites técnicos e direitos de licença. O padrão pode ser uma boa opção para muitas cargas de trabalho departamentais e de médio porte, mas seu teto de computação de 32 núcleos por instância e limites de recursos devem se adequar ao design. A Microsoft oferece diferentes modelos de licenciamento e regras de virtualização; o cálculo correto depende dos núcleos físicos, das máquinas virtuais, do padrão de acesso e dos direitos associados à licença. Revise as orientações de licenciamento do Microsoft SQL Server e os Termos do Produto para tomar a decisão final.
A Licendi oferece uma licença legítima do SQL Server 2025 Standard de segunda mão para organizações que buscam uma rota de licenciamento perpétuo. Uma análise de compra responsável deve preservar a fatura, a descrição do produto, a documentação da licença e as evidências de transferência/proveniência fornecidas para a transação. Confirme se a quantidade, a edição, a métrica e a topologia de implantação correspondem ao design técnico antes da compra e novamente antes da ativação da produção.
O licenciamento de segunda mão pode ser uma opção de aquisição válida em jurisdições relevantes, mas não é motivo para adivinhar. Clusters complexos, arranjos de hospedagem, mobilidade na nuvem, movimentação frequente de VMs ou propriedades mistas físicas/virtuais merecem análise especializada. Mantenha os registros de licenciamento com o inventário de configuração para que as alterações na infraestrutura acionem uma verificação de conformidade, em vez de depender de uma planilha descoberta durante uma auditoria.
Lista prática de implementação
Arquitetura e suporte
- Registre o proprietário da empresa, o proprietário técnico, a classificação de dados, o RTO e o RPO.
- Selecione o host nativo, a VM ou o contêiner com base nas operações e na recuperação, não na moda.
- Escolha RHEL 9/10 ou Ubuntu 22.04/24.04 e XFS ou ext4.
- Registre a edição do SQL Server, a compilação do CU, a compilação do SO, o kernel e o resumo da imagem.
- Confirme cada driver crítico, extensão, componente de cluster e agente de backup são suportados.
- O teto de computação de 32 núcleos do Verify Standard se ajusta à instância.
Construção e segurança
- Automatize a configuração do repositório, instalação de pacotes e configurações aprovadas.
- Recupere segredos de um cofre; mantenha-os fora de scripts, imagens e histórico de shell.
- Instale um certificado de serviço e teste o TLS 1.3 com drivers de cliente de produção.
- Restringa regras de firewall, sudo, propriedade de arquivos e acesso interativo.
- Ative a auditoria necessária e encaminhe o banco de dados e hospede eventos de segurança centralmente.
- Documente o ciclo recorrente de patch de sistema operacional, CU, driver e imagem de contêiner.
Desempenho e dados
- Tamanho da carga de trabalho medida, picos de crescimento e manutenção.
- Reserve memória e espaço de CPU para Linux e agentes operacionais.
- Valide a latência e durabilidade de dados, log, tempdb e armazenamento de backup.
- Defina a memória máxima do servidor e o crescimento de arquivos deliberadamente.
- Use tmpfs apenas para tempdb, com uma capacidade testada e plano de reinicialização.
- Capture um Query Store de pré-produção e linha de base do sistema operacional.
Disponibilidade e recuperação
- Mapeie domínios de falha e remova dependências compartilhadas acidentais.
- Configure quórum, isolamento, ouvinte/DNS e política de failover explicitamente.
- Teste cenários de falha de nó, rede, armazenamento, testemunha e réplica.
- Criptografe backups e mantenha cópias fora do domínio de falha primário.
- Execute e cronometre uma restauração limpa, incluindo chaves e recuperação pontual.
- Escreva runbooks de reconexão, failover, escalonamento e reversão de aplicativos.
Operações e licenciamento
- Alerta sobre o impacto do usuário, esperas de SQL, bloqueio, capacidade, integridade do AG e idade de backup.
- Correlacionar SQL, systemd, sistema operacional, contêiner, cluster e telemetria de armazenamento.
- Atribuir um proprietário e a primeira ação a cada telemetria crítica alerta.
- Inventariar trabalhos, logins, certificados, drivers e dependências antes da migração.
- Validar modelo de licença, métrica, quantidades, evidências e topologia.
- Agendar revisão pós-lançamento de desempenho, segurança, recuperação e conformidade.
Conclusão
O SQL Server 2025 no Linux tem mais sucesso quando é operado como um serviço de banco de dados, e não apenas instalado como outro pacote. Plataformas suportadas, uma linha de base precisa de CU, armazenamento durável, controles cuidadosos de recursos, validação de certificados, recuperação ensaiada e monitoramento útil fazem parte do mesmo design. O Linux oferece às equipes bases sólidas de automação e observabilidade; O SQL Server adiciona suas próprias responsabilidades de estado, transação e licenciamento.
Perguntas frequentes
Quais distribuições Linux suportam o SQL Server 2025?
A Microsoft oferece suporte a instalações nativas no RHEL 9 e 10 e no Ubuntu 22.04 e 24.04, usando XFS ou ext4. RHEL 10 e Ubuntu 24.04 são totalmente suportados pelo CU1.
O SQL Server 2025 oferece suporte a SLES?
Não. SLES não é uma plataforma SQL Server 2025 compatível. Migre uma instância mais antiga hospedada pelo SLES para um destino RHEL ou Ubuntu compatível, normalmente por meio de um plano de backup e restauração lado a lado.
Qual é a atualização mais recente do SQL Server 2025 Linux?
Em 31 de julho de 2026, é CU7, compilação 17.0.4065.4, lançada em 16 de julho de 2026. Sempre verifique novamente as notas de versão antes implantação.
O SQL Server 2025 pode ser executado em um contêiner Linux?
Sim, em hosts Linux x86-64 compatíveis usando processadores Intel ou AMD. Persista o armazenamento do banco de dados, fixe a versão da imagem, proteja segredos e teste o backup e a recuperação fora do contêiner.
Posso colocar bancos de dados SQL Server em tmpfs?
Somente tempdb é compatível com tmpfs. É volátil e baseado em memória, portanto dimensione-o e teste-o com cuidado. Os bancos de dados do usuário e os bancos de dados persistentes do sistema devem permanecer em armazenamento durável com suporte.
A edição Standard usa mais de 32 núcleos?
Uma instância do Standard Database Engine é limitada ao menor entre quatro soquetes ou 32 núcleos. As regras de licenciamento e virtualização ainda precisam ser verificadas para a implantação real.
Os grupos de disponibilidade substituem os backups?
Não. A replicação pode melhorar a disponibilidade, mas também pode reproduzir a exclusão ou a corrupção. Mantenha backups criptografados independentes e execute testes de restauração agendados.
Uma licença de segunda mão do SQL Server é legítima?
Pode ser uma rota de aquisição legítima onde as condições legais e de transferência de licença são atendidas. Preservar documentos de transação e procedência e validar edição, métrica e topologia para a implantação pretendida.




