 ES
 EN
 FR
 DE
 IT
 PT


SigmaPlot: análisis estadístico y gráficos científicos, guía 2026
Un gráfico científico tiene que hacer algo más que quedar bien en una presentación: debe permitir entender qué se midió, cuánto varían los resultados y hasta dónde llega la conclusión. Cuando esos detalles importan, trabajar con una herramienta especializada ayuda a pasar de una tabla de números a una figura que se pueda explicar y revisar.
SigmaPlot reúne gráficos científicos, análisis estadístico y ajuste de curvas en un mismo entorno. Su interés está en conectar esas tareas: explorar los datos, elegir un análisis coherente y representar el resultado sin perder de vista las observaciones originales. Esta guía muestra cómo plantear ese recorrido con ejemplos numéricos hipotéticos y decisiones prácticas para trabajos de laboratorio, ingeniería, investigación y docencia.
El año 2026 corresponde a la guía; la licencia que se comenta es SigmaPlot 14. No son dos nombres para una misma versión ni se atribuyen a esa licencia las novedades de ediciones posteriores.
1. Qué aporta SigmaPlot a un trabajo científico
La ventaja de un programa especializado aparece cuando necesitas controlar detalles que afectan a la interpretación: un eje logarítmico, barras de error asimétricas, varias series sobre las mismas coordenadas o una curva ajustada junto a las mediciones. También cuando debes mantener un estilo legible en muchas figuras sin reconstruir cada una desde cero.
SigmaPlot permite trabajar con hojas de datos, gráficos e informes. Su documentación describe asistentes para crear gráficos y realizar análisis, personalización de ejes y leyendas, regresión y ajuste de curvas. Eso resulta útil, por ejemplo, para comparar materiales, estudiar la respuesta de una muestra a distintas concentraciones o mostrar cómo cambia una señal con el tiempo.
No hace falta enfrentar SigmaPlot con una hoja de cálculo. Puedes organizar inicialmente los registros en una tabla y utilizar después el entorno científico para explorar, modelizar y preparar la figura final. Lo importante es conservar una relación clara entre los valores originales, cualquier transformación aplicada y el resultado que publicas.
Si ese es el tipo de trabajo que realizas, la licencia de SigmaPlot 14 en Licendi es la oferta concreta a revisar. La elección tiene más sentido cuando responde a un análisis habitual que cuando se basa únicamente en la cantidad de tipos de gráfico anunciados.
2. SigmaPlot 14 y una guía de uso en 2026
Conviene separar tres cosas: la versión del programa, la revisión instalada y la fecha de una guía. Un artículo actualizado puede explicar métodos válidos para una versión anterior sin convertirla en la edición más reciente. Grafiti mantiene una página específica de SigmaPlot 14.0 y una sección de actualizaciones que distingue revisiones de diferentes versiones.
Para seguir un procedimiento, consulta la ayuda correspondiente a tu instalación. Un vídeo de otra edición puede ser útil para comprender una idea, pero sus botones, organización de menús o funciones añadidas no tienen por qué coincidir exactamente. Por eso, sigue la secuencia de trabajo y localiza en la ayuda de tu versión las opciones equivalentes. Entender qué debe entrar en cada análisis es más útil que memorizar la posición de un botón.
La oferta consultada describe una licencia permanente para un PC, en inglés, para Windows de 64 bits y con entrega digital. Esa descripción no convierte la compra en una suscripción ni acredita por sí sola actualizaciones a futuras versiones. La versión y el entorno de trabajo deben comprobarse por separado.
3. Preparar los datos antes de elegir una prueba
Empieza por escribir la pregunta en una frase: «¿Cambia la resistencia media entre estos dos materiales?» es más útil que «quiero hacer estadística». Después identifica la variable de respuesta, sus unidades, el factor que quieres comparar y qué constituye una unidad experimental independiente. Esa definición determinará tanto el análisis como el tamaño de muestra.
Una estructura práctica utiliza una fila por observación y columnas para identificador, grupo, respuesta, fecha y cualquier condición relevante. Si hay mediciones repetidas, conserva el identificador de la muestra. Si importas datos desde Excel o un archivo de texto, comprueba el separador decimal, los encabezados y que las columnas numéricas no se hayan interpretado como texto.
No sustituyas automáticamente los valores ausentes por cero: cero puede ser un resultado válido y cambiaría medias, dispersiones y pendientes. Tampoco conviertas un valor por debajo del límite de detección en una medida exacta sin justificar cómo lo tratarás. Guarda una copia de los datos originales y registra las correcciones.
Cuando encuentres un valor extremo, vuelve al registro de origen. Puede ser un error de transcripción, una incidencia del instrumento o una observación genuina. Corregir un error comprobado no es lo mismo que eliminar un dato incómodo. Si existe una razón válida para excluirlo, deja constancia y valora cuánto cambia la conclusión al incluirlo.
Una última comprobación evita muchos errores: contar cuántas unidades independientes hay realmente. Medir tres veces la misma probeta no equivale a disponer de tres probetas. Las repeticiones técnicas sirven para estudiar la precisión de la medición, pero tratarlas como muestras independientes puede hacer que la incertidumbre parezca menor de lo que es.
4. Del archivo de datos al primer gráfico
Antes de abrir una prueba estadística, prepara una representación sencilla. El objetivo inicial es detectar valores inesperados, grupos mal etiquetados o cambios de escala; todavía no necesitas una figura lista para publicar. En SigmaPlot, el recorrido general pasa por la hoja de datos, la selección de columnas y el asistente del tipo de gráfico elegido.
- Comprueba la importación. Contrasta varias filas con el archivo original, especialmente decimales, signos negativos y observaciones ausentes.
- Asigna correctamente las variables. Para una relación entre concentración y respuesta, la concentración va en X y la respuesta en Y.
- Muestra primero las observaciones. Un diagrama de dispersión permite ver la estructura que una línea o una barra podría ocultar.
- Identifica unidades y grupos. «Tiempo (min)» informa más que «Variable 1»; una leyenda breve evita explicaciones posteriores.
- Guarda una versión exploratoria. Así podrás comparar el aspecto de los datos antes y después del análisis.
Si aparecen puntos superpuestos, un pequeño desplazamiento horizontal puede ayudar en grupos categóricos, siempre que no cambie el valor de la respuesta. En un gráfico con una X cuantitativa, en cambio, no desplaces las coordenadas sin explicarlo: podrías alterar visualmente la relación que estás estudiando.
Al pasar al análisis, distingue entre columnas con observaciones originales y columnas con medias ya calculadas. Seleccionar seis medias como si fueran seis mediciones individuales cambia la unidad de análisis. Conserva los resultados descriptivos en un lugar separado y comprueba en el informe el número de observaciones utilizadas; ese recuento descubre rangos incompletos y celdas omitidas.
La primera figura también sirve para conversar con un compañero: si no se entiende qué representa cada punto, conviene resolverlo antes de interpretar cualquier resultado numérico.
5. Un ejemplo completo con dos grupos independientes
Imagina que comparas la resistencia, en megapascales, de dos formulaciones. Dispones de seis probetas independientes por formulación y obtienes los siguientes datos inventados para practicar. No son resultados de un ensayo real ni una demostración experimental de un producto.
| Observación dentro del grupo | Formulación A | Formulación B |
|---|---|---|
| 1 | 8 | 10 |
| 2 | 9 | 11 |
| 3 | 10 | 12 |
| 4 | 10 | 12 |
| 5 | 11 | 13 |
| 6 | 12 | 14 |
Las filas no representan parejas: la primera probeta de A no está vinculada a la primera de B. Las medias son 10 y 12 MPa, respectivamente. La diferencia B menos A es 2 MPa, equivalente a un incremento del 20 % respecto a la media de A. Ese porcentaje describe estas medias; no dice que todas las probetas mejoren un 20 %.
Para A, las desviaciones respecto a la media son −2, −1, 0, 0, 1 y 2. Sus cuadrados suman 10. La varianza muestral divide esa suma entre cinco, no entre seis: resulta 2 MPa². La desviación estándar es la raíz de 2, aproximadamente 1,41 MPa. B tiene exactamente la misma dispersión.
Al introducir el ejemplo, comprueba primero que recuperas esos valores. Es una verificación sencilla de las columnas seleccionadas y del uso de la desviación estándar muestral. Después representa los doce puntos y añade el resumen que responda a tu pregunta, sin esconder los datos detrás de dos barras opacas.
6. Desviación estándar, SEM e intervalo de confianza
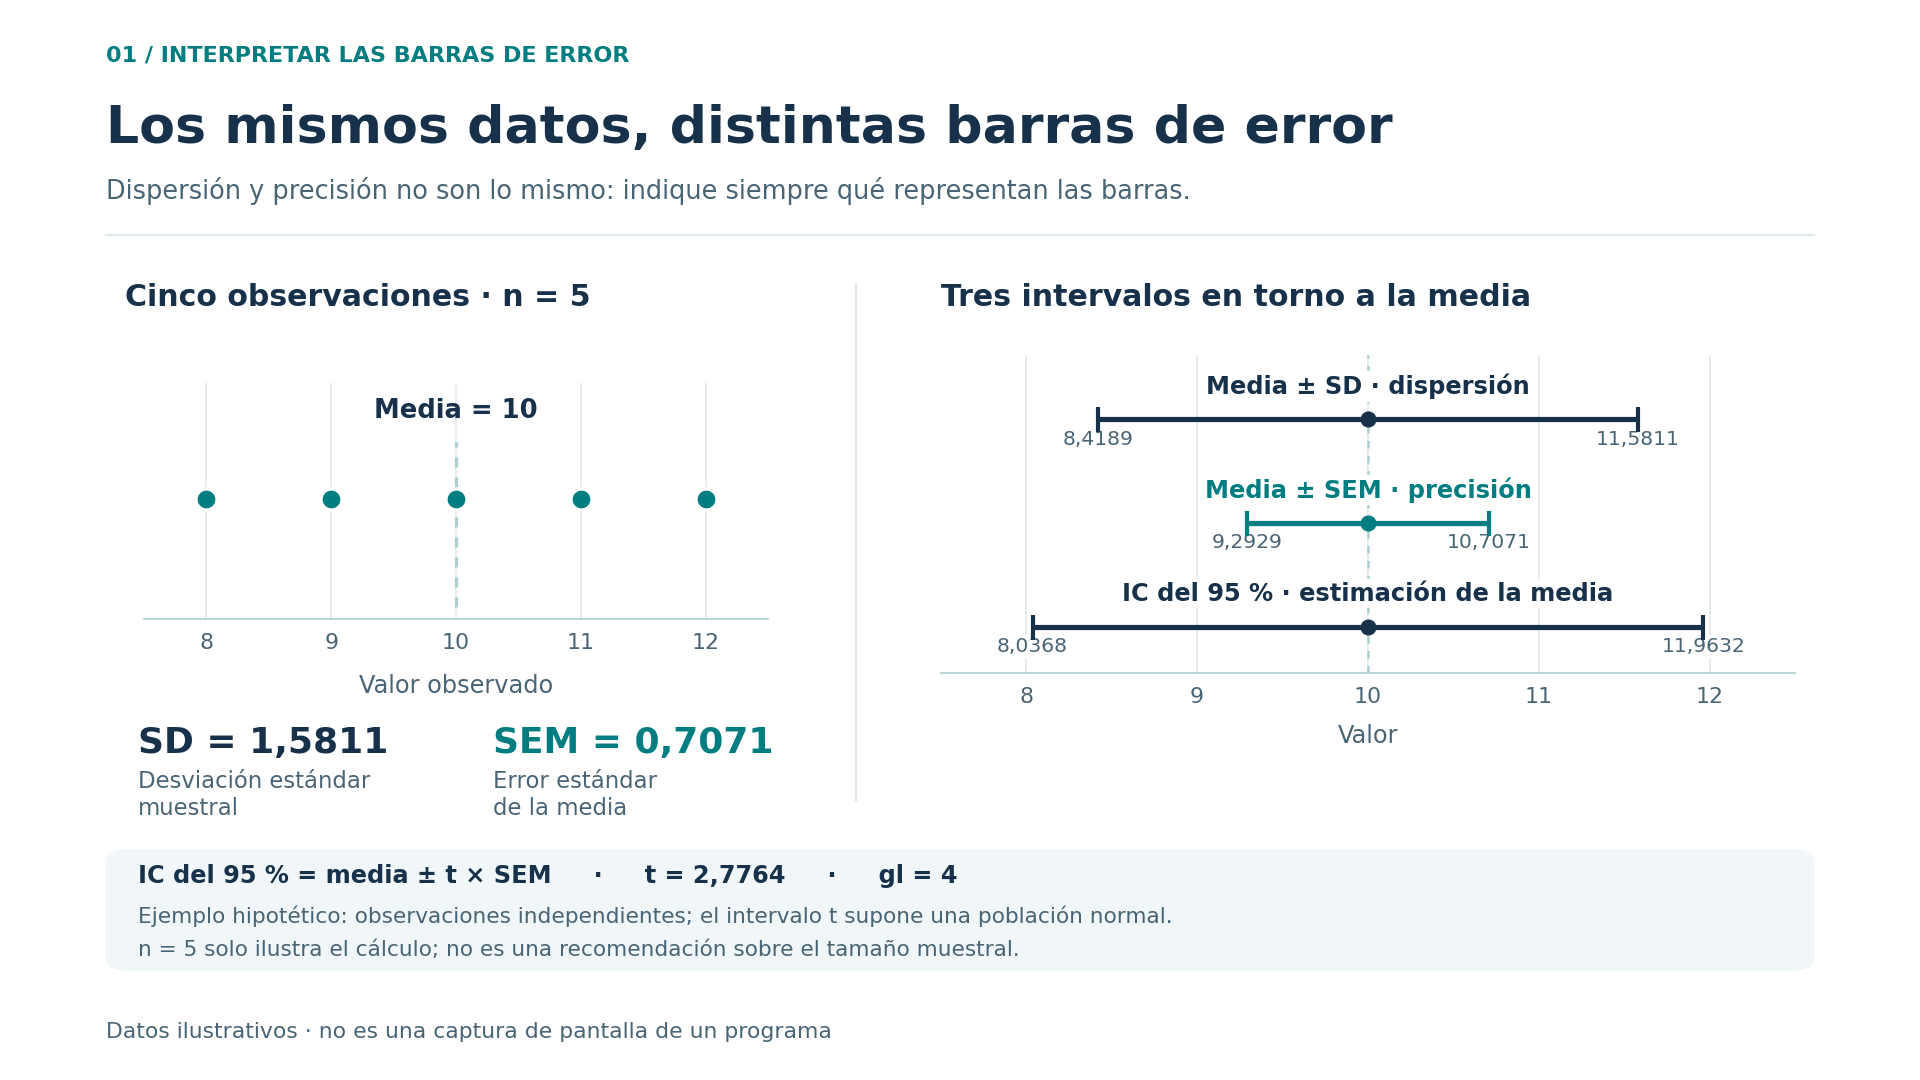
Estas tres medidas no son intercambiables. La desviación estándar, abreviada DE o SD, describe la dispersión de las observaciones alrededor de su media. En el ejemplo vale 1,41 MPa por grupo. Es adecuada cuando quieres mostrar cuánto varían las probetas.
El error estándar de la media, SEM, cuantifica la incertidumbre de la media estimada bajo los supuestos del muestreo. Se calcula como SD dividida entre la raíz cuadrada de n. Aquí, 1,414 dividido entre la raíz de seis da aproximadamente 0,577 MPa. Que sea menor que la SD no significa que las probetas sean más uniformes.
Un intervalo de confianza del 95 % añade un margen alrededor de la estimación. Para una media con desviación poblacional desconocida y el modelo habitual de observaciones independientes normales, se utiliza la distribución t. Con seis observaciones, el multiplicador es aproximadamente 2,571: el margen resulta 1,484 MPa. Los intervalos son 8,52–11,48 MPa para A y 10,52–13,48 MPa para B.
Calcula con la precisión disponible y redondea al presentar. Si sustituyes prematuramente 0,577 por 0,6, pequeñas diferencias se acumulan en los límites. En una figura, dos decimales pueden bastar; en el archivo de cálculo, conserva los valores sin ese redondeo.
La interpretación del 95 % se refiere al procedimiento: al repetir el muestreo muchas veces bajo los mismos supuestos, alrededor del 95 % de los intervalos construidos así contendrían la media poblacional. No significa que el 95 % de las probetas esté dentro del intervalo.
7. Comparar las medias sin depender del aspecto del gráfico
Para dos grupos independientes con una respuesta cuantitativa, una comparación de medias puede plantearse mediante una prueba t. La variante de Welch no exige asumir igualdad de varianzas poblacionales. La elección debe corresponder al diseño y a los supuestos, no al procedimiento que produzca el menor valor p.
En el ejemplo de las formulaciones A y B, el error estándar de la diferencia es la raíz cuadrada de 2/6 + 2/6: aproximadamente 0,816 MPa. Dividir la diferencia de 2 MPa entre ese valor produce un estadístico t de 2,449. La comparación bilateral de Welch tiene aquí diez grados de libertad y da p ≈ 0,0343. El intervalo de confianza del 95 % para B menos A es aproximadamente 0,18–3,82 MPa.
Los intervalos individuales de A y B se solapan, pero el intervalo de la diferencia no incluye cero. No hay contradicción: son intervalos para parámetros distintos. Por eso no conviene decidir la significación de una diferencia mirando únicamente si se tocan las barras de dos medias.
Con muestras pequeñas, revisa con especial cuidado observaciones extremas y la plausibilidad del modelo. Una prueba de normalidad que no detecta problemas no demuestra que la distribución sea normal. En SigmaPlot, lee las comprobaciones y el informe completo, pero conserva el razonamiento sobre cómo se obtuvieron los datos: ningún asistente puede reconstruir un diseño experimental que no se ha documentado.
8. Cuándo los datos son pareados
Si mides las mismas muestras antes y después de un tratamiento, la pregunta cambia. Ahora interesa cuánto cambia cada muestra, no simplemente comparar dos colecciones como si fueran independientes. Las observaciones están pareadas porque existe una correspondencia real, establecida por el diseño.
Organiza las columnas con un identificador y las dos mediciones. Calcula el cambio de cada unidad manteniendo siempre el mismo sentido, por ejemplo después menos antes. Una prueba t pareada analiza la media de esos cambios; su supuesto de normalidad se refiere a las diferencias, y las distintas parejas deben ser independientes entre sí.
Un gráfico de puntos conectados permite ver algo que las medias pueden ocultar: algunas muestras mejoran mucho, otras poco y alguna puede empeorar. Si falta una de las dos mediciones, no emparejes la observación restante con otra muestra para completar la fila. Documenta la ausencia y el criterio de análisis.
Tener el mismo número de datos en dos columnas no los convierte en pareados. Tampoco basta con que ambos grupos se midieran el mismo día. En sentido contrario, ignorar un pareamiento auténtico puede desaprovechar información. Si existen más tiempos, agrupaciones por centro o varias observaciones por sujeto, el diseño requiere una estrategia que represente esa dependencia.
9. Más de dos grupos: ANOVA y comparaciones planificadas
Con tres formulaciones, hacer una prueba t para cada pareja parece una prolongación natural del ejemplo, pero multiplica las oportunidades de obtener resultados aparentemente significativos por azar. Un ANOVA de un factor plantea primero una pregunta global: si las medias poblacionales de los grupos son iguales.
Un resultado global significativo no identifica por sí solo qué grupos difieren. Para responder a esa segunda pregunta hay que definir contrastes o comparaciones múltiples apropiados. Si solo interesa comparar cada formulación con un control, el objetivo no es el mismo que comparar todas las parejas. Conviene decidirlo antes de observar los resultados.
El ANOVA clásico incluye supuestos sobre independencia, distribución de los errores y homogeneidad de sus varianzas. Examinar los residuos ayuda a valorar el ajuste del modelo. Cuando los supuestos no resultan adecuados, considera métodos para varianzas diferentes, transformaciones justificadas o alternativas basadas en rangos, según la pregunta y las herramientas disponibles.
Los métodos no paramétricos tampoco son una solución automática para cualquier conjunto de datos. Conservan requisitos de diseño y no siempre contrastan la misma propiedad que una comparación de medias. En el informe, identifica qué parámetro o aspecto de la distribución estás comparando; cambiar de prueba sin revisar la interpretación puede responder a una pregunta distinta de la original.
10. Qué significa un valor p y qué falta por contar
Un valor p resume cuán incompatibles son los datos con una hipótesis nula y el modelo utilizado: expresa la probabilidad, bajo esas condiciones, de obtener un estadístico tan extremo o más que el observado. No es la probabilidad de que la hipótesis nula sea verdadera, ni una medida directa de la importancia del efecto.
En el ejemplo, p ≈ 0,0343 acompaña a una diferencia estimada de 2 MPa. Si una mejora inferior a 1 MPa carece de utilidad técnica, el intervalo 0,18–3,82 MPa deja abierta esa cuestión: contiene valores por debajo y por encima del umbral práctico. Hay evidencia de una diferencia dentro del modelo, pero su magnitud sigue siendo imprecisa.
Por la misma razón, p superior a 0,05 no demuestra equivalencia. Puede reflejar una diferencia pequeña, una muestra insuficiente o datos muy variables. Demostrar equivalencia exige definir un margen relevante y un procedimiento específico; no basta con que una comparación convencional no resulte significativa.
Una redacción informativa sería: «En este ejemplo hipotético, B superó a A en 2 MPa; IC del 95 % de la diferencia: 0,18–3,82 MPa; prueba t bilateral de Welch, p = 0,0343; seis probetas independientes por grupo». El lector recibe el tamaño del efecto, su incertidumbre y el diseño, no solo un asterisco.
11. Regresión: mirar la curva y también los residuos
Cuando la pregunta es cómo cambia una respuesta con una variable cuantitativa, la regresión resulta más informativa que dividir artificialmente esa variable en grupos. Empieza con un diagrama de dispersión y un modelo compatible con el fenómeno. En una recta, la pendiente expresa el cambio esperado en Y por cada unidad adicional de X.
Considera otro ejemplo construido para practicar: X toma los valores 0, 1, 2, 3, 4 y 5; Y vale 1,2; 2,8; 4,8; 7,2; 9 y 11. El ajuste ordinario por mínimos cuadrados es Y estimada = 1 + 2X. Sus residuos, observación menos predicción, son 0,2; −0,2; −0,2; 0,2; 0 y 0. El R² es aproximadamente 0,9977.
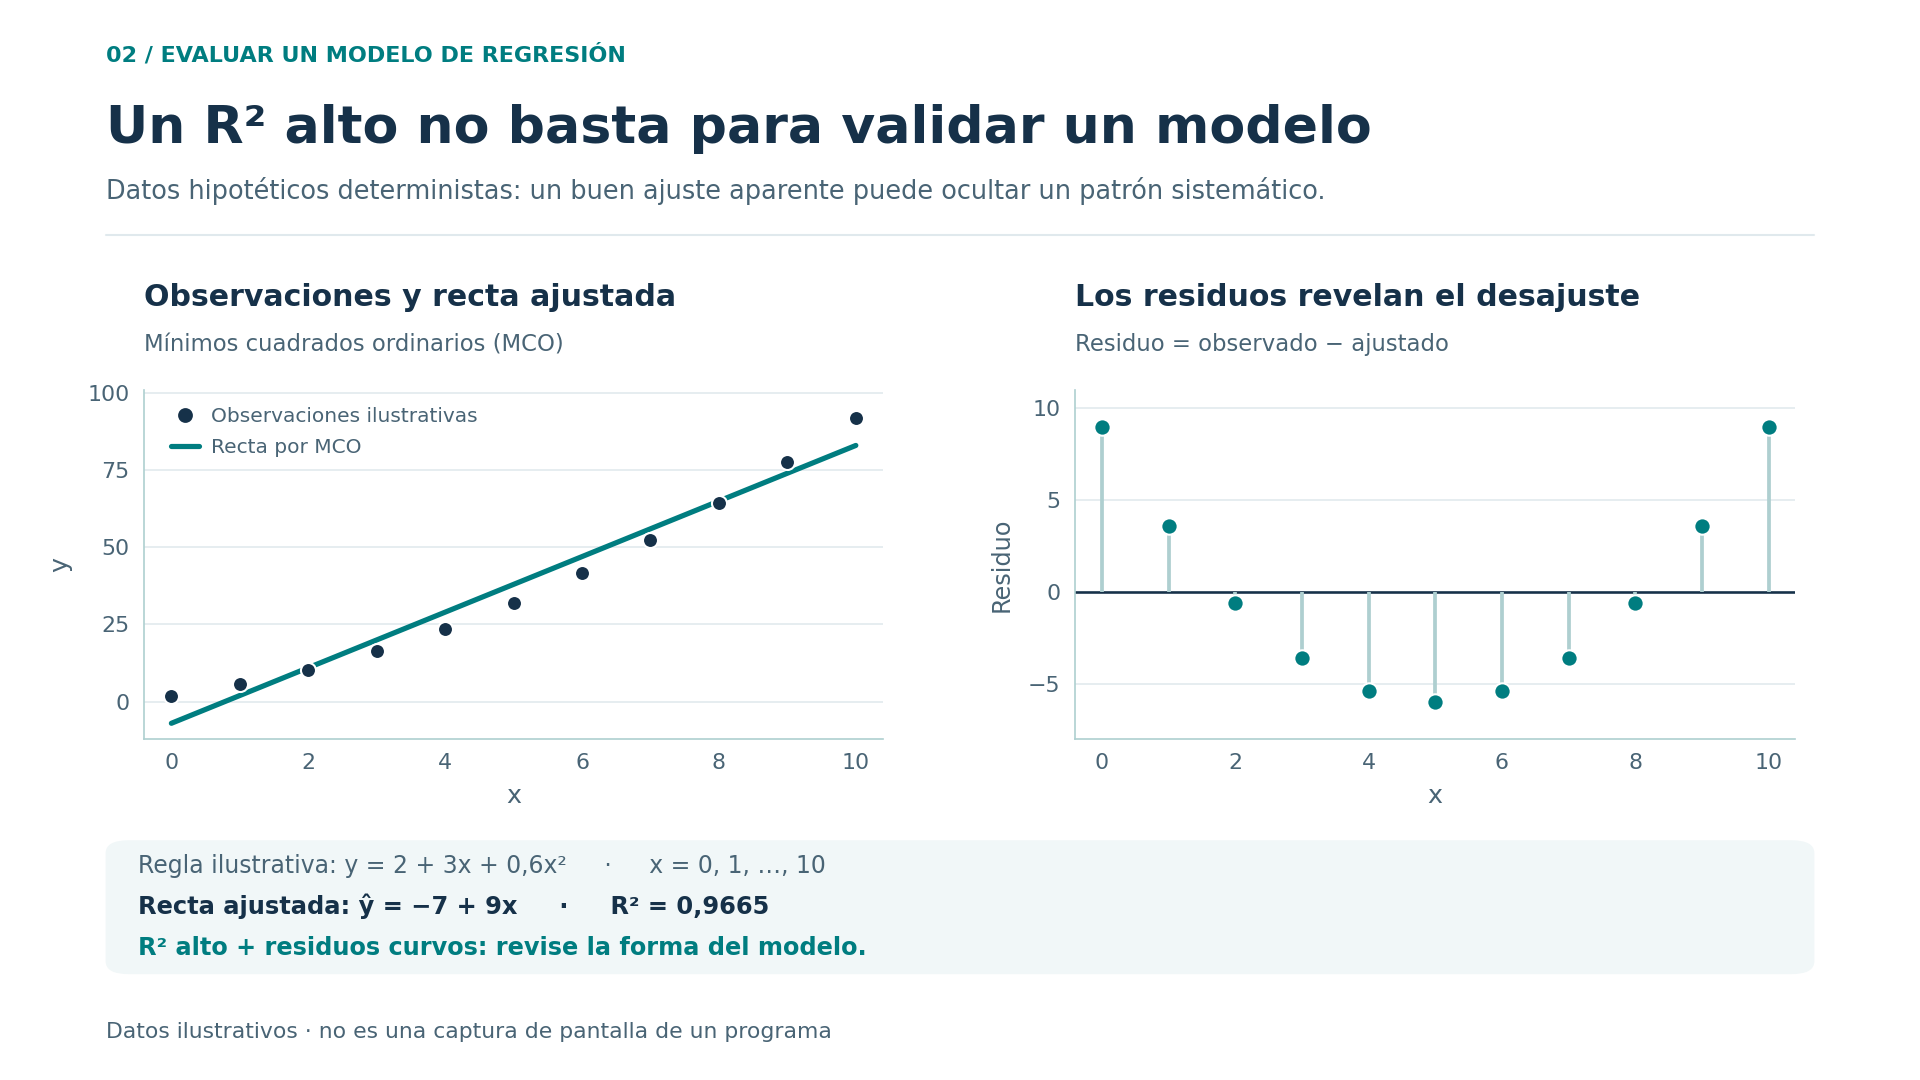
Ese valor resume el ajuste, pero no sustituye el diagnóstico. Una curvatura en los residuos sugiere una forma funcional inadecuada; un abanico puede indicar variabilidad no constante; una secuencia temporal puede revelar dependencia o deriva. Seis puntos ofrecen información limitada: un dibujo aparentemente limpio tampoco certifica todos los supuestos.
Una asociación tampoco establece causalidad. Si temperatura y respuesta aumentan juntas, puede existir un mecanismo directo, una tercera variable o una tendencia temporal compartida. La interpretación depende del diseño, los controles y el conocimiento del proceso, no solo de la pendiente. Regresión describe relaciones; un experimento bien planteado permite investigar sus causas.
Para ver el problema, utiliza ahora X = 0, 1, …, 10 y calcula Y = 2 + 3X + 0,6X². Una recta obtiene R² ≈ 0,9665, aunque los residuos dibujan una U clara: los datos se construyeron con una relación cuadrática. Es un ejemplo de por qué «R² alto» no equivale a «modelo adecuado».
12. Ajuste no lineal sin perseguir la curva más bonita
Una respuesta que se aproxima a una meseta, una degradación exponencial o una relación dosis-respuesta pueden requerir modelos no lineales. SigmaPlot dispone de herramientas de ajuste de curvas; la documentación de Grafiti explica tanto el asistente de regresión como la búsqueda de valores iniciales mediante ajuste dinámico.
El paso decisivo sigue siendo escoger una ecuación con sentido. Añadir parámetros suele facilitar que la curva se acerque a los puntos, pero puede producir estimaciones inestables y predicciones pobres. Si no has medido cerca de una meseta, por ejemplo, el valor asintótico podría quedar muy mal determinado aunque la curva parezca convincente.
Anota la ecuación, las unidades de sus parámetros, los valores iniciales, las restricciones y cualquier ponderación. Prueba varios puntos de partida razonables cuando el problema lo requiera. La convergencia numérica significa que el algoritmo ha llegado a una solución según sus criterios; no demuestra que sea la única ni que el modelo describa correctamente el proceso.
La ponderación merece una decisión explícita. Si unas observaciones tienen mayor varianza que otras, darles a todas el mismo peso puede no ser apropiado. Los pesos deben reflejar un modelo de incertidumbre defendible, no servir para acercar la curva a los puntos favoritos. Explica de dónde proceden y revisa los residuos de forma coherente.
Distingue también interpolación y extrapolación. Estimar dentro del intervalo medido tiene un respaldo diferente de prolongar una curva hacia concentraciones o tiempos no observados. Si presentas una predicción, explica su dominio de validez. Y no confundas el intervalo de confianza de la respuesta media con el intervalo de predicción de una observación nueva: este último incorpora variabilidad adicional.
13. Elegir el gráfico que responde a la pregunta
Para comparar grupos pequeños, los puntos individuales suelen ser más informativos que una barra con la media. Con más observaciones, un diagrama de caja puede resumir la distribución, siempre que expliques qué representan la caja y los bigotes. Un histograma ayuda a explorar forma y asimetría, aunque su aspecto depende de los intervalos elegidos.
Para dos variables cuantitativas, utiliza dispersión. Para una evolución temporal, una línea puede ayudar a seguir el orden, pero no debe sugerir mediciones que nunca se realizaron. En diseños pareados, conectar las observaciones de la misma unidad hace visible su trayectoria. En todos los casos, la representación debe respetar cómo se recogieron los datos.
Los gráficos tridimensionales tienen sentido cuando una tercera dimensión aporta información real. Si solo sirven para dar volumen a unas barras, añaden perspectiva y dificultan comparar alturas. Para varias condiciones experimentales, pequeños paneles con escalas coherentes pueden funcionar mejor que una sola figura sobrecargada.
Antes de decidirte por una herramienta, piensa en dos o tres figuras que produzcas habitualmente. Revisar las posibilidades de SigmaPlot 14 para gráficos científicos y análisis de datos con esos ejemplos en mente permite valorar su utilidad concreta: no necesitas utilizar todas las opciones para aprovechar un entorno especializado.
14. Ejes, barras de error y leyendas que no engañan
Los ejes son parte del argumento. En un gráfico de barras, empezar el eje vertical lejos de cero puede exagerar diferencias porque comparamos longitudes. En una dispersión, un intervalo recortado puede ser razonable para estudiar variaciones pequeñas, siempre que la escala sea clara y no se oculte información relevante.
Una escala logarítmica ayuda cuando los valores positivos abarcan varios órdenes de magnitud o interesan cambios multiplicativos. Debe identificarse correctamente y no admite cero ni valores negativos en su forma habitual. Cambiar la escala visual tampoco equivale necesariamente a transformar la variable para el análisis: registra ambas decisiones por separado.
Especifica siempre qué muestran las barras de error: SD, SEM, intervalo de confianza u otra medida. Si introduces límites inferior y superior, verifica si el diálogo espera límites absolutos o distancias respecto al valor central. Confundir ambos formatos desplaza las barras aunque los números de origen sean correctos.
Usa colores distinguibles y combínalos con símbolos o estilos de línea. Comprueba que la figura se entienda también en escala de grises. Una leyenda útil identifica los grupos, el tamaño de muestra y el resumen representado; no necesita repetir todo el apartado de métodos. Retira decimales innecesarios, fondos decorativos y cuadrículas que compitan con las observaciones.
15. Exportar y conservar un análisis reproducible
Piensa en el destino antes de exportar: una diapositiva, una memoria y una revista pueden exigir tamaños distintos. Siempre que el destino y la instalación lo permitan, un formato vectorial conserva nítidas líneas y etiquetas al redimensionar. Si necesitas una imagen de mapa de bits, establece dimensiones suficientes para su tamaño final, no solo un número de resolución.
Reabre el archivo exportado fuera del programa. Comprueba caracteres especiales, unidades, superíndices, grosor de líneas y posibles recortes. Una etiqueta que parece cómoda en pantalla puede resultar ilegible al reducir la figura a una columna. También revisa que la versión enviada coincida con la última revisión de los datos.
Para poder repetir el trabajo, conserva los datos originales, la tabla preparada, el archivo editable, los informes y la figura final. Añade un registro breve con versión y revisión del software, exclusiones justificadas, transformaciones, prueba utilizada y opciones relevantes. En ajustes, guarda además la ecuación y las decisiones sobre parámetros y ponderación.
Una carpeta ordenada no es burocracia: permite responder a una revisión sin reconstruir el experimento de memoria. Si otra persona recibe el proyecto, debería poder identificar de dónde sale cada panel y qué cambió entre dos entregas. Reproducibilidad significa conservar las decisiones, no únicamente volver a generar una imagen parecida.
16. Cómo elegir la licencia con criterio
La compra resulta más sencilla cuando sabes qué necesitas producir. Haz una lista corta: tipos de gráfico habituales, pruebas estadísticas necesarias, intercambio de archivos y equipo donde trabajarás. Si colaboras con un laboratorio, comprueba también qué versión utilizan y qué formato necesitan para revisar los resultados.
La oferta de Licendi identificada para esta guía es SigmaPlot 14: licencia permanente para un PC, idioma inglés, Windows de 64 bits y entrega digital. El idioma importa para seguir menús y documentación; el número de equipos importa para planificar el puesto de trabajo. La compatibilidad de un sistema concreto debe contrastarse con los requisitos correspondientes a esa versión.
«Permanente» describe la duración de la licencia ofrecida, no una promesa de nuevas versiones, compatibilidad con cualquier futuro sistema o servicios ilimitados. Si necesitas condiciones particulares de instalación, traslado o uso en varios puestos, acláralas antes de comprar en lugar de deducirlas del nombre del producto. Así eliges por necesidades reales sin confundir modalidades distintas.
Puedes consultar la ficha de SigmaPlot 14 y sus condiciones en Licendi para valorar esa configuración. El objetivo final no es acumular funciones: es disponer de un recorrido claro entre datos, análisis y figura. Cuando cada punto, barra y conclusión tiene una explicación, el programa se convierte en una ayuda práctica para comunicar mejor tu trabajo.
17. Fuentes y documentación para profundizar
Documentación oficial consultada para las funciones generales, la distinción entre versiones y los fundamentos estadísticos:




